En svensk formulärspecialist i ett enda framåtpass
Kan en liten lokal modell ta hand om rutinbeslut i formulär? Vi tränade en svensk specialist och undersökte sedan vad resultatet på syntetiska data inte berättade.

Kapitel
En e-postadress finns redan i dokumentet. Ett tomt fält i ett formulär frågar efter ”E-postadress”. Någonstans mellan de två måste programvaran avgöra att de hör ihop. Upprepat genom ett formulär blir de små besluten ett arbete som någon måste göra.
En stor språkmodell kan hjälpa till att läsa dokumentet och förstå uppgiften. Men när applikationen väl har värdena och vet vilka åtgärder som är möjliga, skulle en mycket mindre modell kunna ta hand om de återkommande valen?
Det är en tilltalande uppgift för en lokal specialist. Varje beslut skulle kunna fattas inne i applikationen, utan ett nätverksanrop eller ett genererat svar att tolka. Vanlig kod skulle fortfarande styra arbetsflödet och kontrollera resultatet. Tanken är att göra rutinarbetet lättare att automatisera och samtidigt hålla modellens uppgift tillräckligt liten för att kunna granska den.
Vi tränade en svensk formulärspecialist med 706 048 parametrar, en öppen arkitektur och syntetiska data. Den väljer ett alternativ i ett enda framåtpass. De publicerade modellvikterna ger 99,29 % rätt på syntetiska beslut som hållits utanför träningen. På två förenklade testfixturer baserade på formulär från våra egna webbplatser blir resultatet 52,8 % och 77,3 %.12
Den praktiska frågan är hur långt man kan lita på den lilla komponenten i just det här jobbet. Därför tittade vi bortom totalsiffran: på fälten den lämnar tomma, formulär utanför träningsgeneratorn och vad som händer när samma modell körs på ett annat sätt.
Ge modellen en meny
I september presenterade TypeSafe Jev och dess System One-gränssnitt: beskriv ett tillstånd, ställ strukturerade frågor och få typade beslut och sannolikheter tillbaka. Det lockande är den korta vägen från modellens svar till vanlig applikationskod.3
Flera öppna projekt utforskar besläktade idéer. jevlike implementerar ett attention-huvud som poängsätter alternativ. Cua-S1 använder angreppssättet för formulärbeslut, med en liten modell som arbetar på bytenivå och tränas på syntetiska data. Laya utforskar fler typer av beslut med förtränade kodare, bland annat flerspråkiga modeller. Det är olika implementationer och träningsupplägg, inte utbytbara versioner av Jev.4
Vårt svenska experiment använder Cuas modell och träningskod. En kopia av uppströmskoden ingår i verktygspaketet, med hänvisning till upphovspersonerna. Vi tränade nya vikter från grunden. Det vi beskriver här är den svenska begreppskatalogen, anpassningen av generatorn, utvärderingen och Core ML-verktygen.5
För ett tomt fält ser gränssnittet ungefär ut så här:
Kontext:
  Formulär: patientregistrering
  Element: textfält, etikett ”E-postadress”, nuvarande värde tomt

Tillgängliga alternativ:
  fyll Förnamn: Anna
  fyll E-post: anna@example.invalid
  kryssa
  klicka
  hoppa över
De faktiska indata använder svenska etiketter och åtgärdsord. Det förenklade exemplet visar en viktig del av gränssnittet: värdet att välja finns redan bland modellens indata. Att läsa ett dokument och plocka ut e-postadressen är en separat uppgift.
Modellen kodar kontexten och alternativen, låter varje alternativ använda attention över kontexten och räknar fram en poäng för varje val. Alla kandidater för det aktuella elementet poängsätts tillsammans. Det finns inget svar att generera eller tolka token för token.
Det här är ett pass per beslut om ett element, inte ett pass för att fylla i hela formuläret. Kod avgör fortfarande vilket element som ska granskas härnäst, validerar åtgärden, matar in värdet och kontrollerar vad som hände. En modell med en begränsad meny kan inte hitta på en ny e-postadress, men den kan välja fel adress ur listan, hoppa över ett användbart fält eller klicka vid fel tillfälle.
För ett formulär som vi äger och känner väl kan uttryckliga regler för vilket värde som hör till vilket fält vara en bättre lösning. Det intressanta fallet är variation: etiketter, synonymer och delvis ifyllda formulär som gör sådana regler mindre enkla.
Att lära ut ordförrådet
Den svenska katalogen innehåller 50 begrepp. Varje begrepp kopplar samman etiketter i formulär med etiketter som kan stå vid ett värde i ett dokument, tillsammans med en generator för syntetiska värden. För e-post ingår formuläretiketterna ”E-post”, ”E-postadress” och ”Mejladress”; i dokument kan det stå ”E-post”, ”E-postadress” eller ”Mejl”.6
Generatorn kombinerar begreppen till formulärepisoder. Den varierar vilka uppgifter som finns, lägger till distraherande alternativ och skapar delvis ifyllda tillstånd. En episod ger flera beslut med facit: fyll i det här fältet, lämna det där, kryssa i en ruta eller klicka på knappen. Uppdelningen styrs av en formulärsignatur byggd från fältens begrepp. Episoder med samma signatur och alla deras beslut hålls samman i träning, validering eller test.
Testdelen kommer alltså inte från en helt annan värld av formulär. Alla tre delarna bygger fortfarande på samma katalog och generator. Det spelar roll när vi tolkar resultatet.
Vi provade tre datamängder med den korrigerade generatorn. Modellen, upplägget med fyra epoker och batchstorleken 64 var oförändrade.7
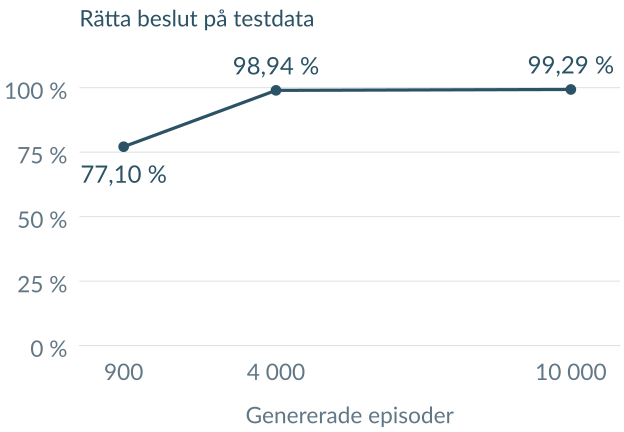
Fler genererade episoder med samma upplägg på fyra epoker. Varje körning har sin egen testmängd.
Den största datamängden innehåller 234 921 träningsbeslut, 29 649 valideringsbeslut och 29 839 testbeslut. De fyra träningsepokerna tog omkring 163 minuter på en Apple M4. Slumpfröet för datamängden är 2026 och för träningen 7; inlärningshastigheten är 0,002.789
Förbättringen är stor mellan de två första körningarna och mindre mellan de två senare. Vi bör akta oss för att göra de tre punkterna till en allmän regel. Större datamängder ger också fler optimeringssteg vid ett fast antal epoker, och varje körning har sin egen testmängd. Experimentet skiljer inte effekterna åt och visar inte att träningen har nått en platå.
Som jämförelse får Cuas oförändrade engelska modell 20,75 % rätt på samma 29 839 svenska testbeslut. Det är en användbar varning inför att flytta just den här specialisten till nya indata. Det är inget allmänt mått på förmåga i engelska respektive svenska: både etiketter, åtgärdssträngar och den genererade datans fördelning ändras.10
Vad totalsiffran inte berättar
Top-1 accuracy mäter om alternativet med högst poäng är precis det som förväntas. Det är en bra första mätning, men olika misstag får olika följder.
I det största syntetiska testet är nästan hälften av de förväntade åtgärderna ”hoppa över”. Ett system som alltid hoppar över skulle få 47,36 % rätt utan att fylla i någonting. För att förstå 99,29 % behöver vi också se resultatet uppdelat per åtgärd.
Av 13 844 förväntade ifyllnadsbeslut hoppar den publicerade modellen tyst över ett. Med ”tyst överhoppning” menar vi här att modellen väljer ”hoppa över” när testet förväntar sig ifyllnad. Det omfattar inte att välja fel värde, vilket är ett annat sätt att misslyckas med ifyllnaden. Andelen rätt vid ifyllnad är 99,00 %, något lägre än totalresultatet.1
Vi parar också avsiktligt ihop fel kontext med alternativen. I den syntetiska utvärderingen roteras kontexter mellan exempel inom en batch, medan alternativen och facit ligger kvar. Andelen rätt faller till 31,99 %. Modellen använder kontexten; resultatet kommer inte enbart från regelbundenheter i alternativen. Kontrollen berättar däremot inte vilka ledtrådar i kontexten den har lärt sig.
En liten handskriven testmängd ger ytterligare en kontroll. Modellen får alla 50 beslut rätt, men det handlar om 32 ifyllnader, 12 överhoppningar, tre kryss och tre klick. Det är användbara exempel att granska, men inte tillräckligt underlag för ett brett påstående om svenska formulär.
Utanför generatorn
Vi byggde sedan testfixturer utifrån intresseformulären hos Kanslist och Pratsam. De kombinerar fältdefinitioner med syntetiska värden och en handskriven tabell över förväntade åtgärder. Femton scenarier per formulär ger 195 beslut för Kanslist och 75 för Pratsam.2
Det här är förenklade representationer av formulären, inte tester i en webbläsare eller riktiga inskick. Vissa etiketter och kontroller skiljer sig från dagens webbplatser, och samma fält återkommer i alla femton scenarierna. Siffrorna mäter beslut i fixturerna, inte andelen besökare vars formulär skulle bli korrekt ifyllda.
| Test | Beslut | Rätt alternativ | Överhoppad förväntad ifyllnad |
|---|---|---|---|
| Syntetisk testmängd | 29 839 | 99,29 % | 1 / 13 844 |
| Kanslist-fixtur | 195 | 52,8 % | 57 / 65 |
| Pratsam-fixtur | 75 | 77,3 % | 0 / 8 |
Kanslist-resultatet är särskilt talande. Modellen lämnar 57 av 65 förväntade ifyllnader ogjorda. Bland dem finns frivilliga fält på webbplatsen där ett syntetiskt scenario tillhandahåller ett värde; det är alltså inte bara obligatoriska fält. Ett till synes harmlöst ”hoppa över” kan ändå innebära att uppgiften inte blev gjord.
Även Pratsams högre totalsiffra behöver tolkas varsamt. Där finns bara åtta förväntade ifyllnader, samtliga e-postadresser. Modellen klarar dem, men inget av de förväntade kryssen eller klicken. Många av de korrekta besluten är att hoppa över.
När vi granskade fixturkoden hittade vi ett problem i själva testet: scenariot för radioval använder ”mig själv”, medan logiken för förväntad åtgärd letar efter ”ja”. Därför får alla radioval ”hoppa över” som facit. Det gör den delen av Pratsams resultat preliminär. Att kunna återskapa en siffra är inte samma sak som att ha validerat vad den mäter.
Det finns flera saker att undersöka härnäst. Kanslist frågar efter en roll i föreningen, antal lägenheter, förvaltare och kommunikationsverktyg. Mycket av det ordförrådet ligger utanför träningskatalogen. Men ordförrådet är en hypotes, inte en fullständig förklaring: även kontrollernas roller, indatalängder och fixturernas sätt att koppla värden till fält skiljer sig åt.
Innan vi tränar om modellen är nästa användbara steg att anpassa fixturerna till de faktiska kontrollerna och rätta facit. Sedan kan vi hålla undan en granskad testmängd och variera träningsordförrådet. Fler episoder från den befintliga generatorn skulle inte i sig pröva om de saknade begreppen har lärts in.
Liten nog att ha nära till hands
En fördel med en modell i den här storleken är att den kan finnas nära applikationen. Vi exporterade de publicerade modellvikterna till Core ML och mätte tre paketvarianter. I en uppföljande jämförelse på en Apple M4 testades varje variant med samma indata under två körkonfigurationer.11
| Exportupplägg | Paketstorlek | Enbart CPU | CPU + Neural Engine tillåtet |
|---|---|---|---|
| Float16 | 1 472 KiB | 99,28 % | 99,29 % |
| 8-bitars vikter | 787 KiB | 99,31 % | 99,29 % |
| 4-bitars vikter | 481 KiB | 99,27 % | 49,92 % |
Andel rätt på samtliga 29 839 testbeslut, utan att utesluta uppvärmningsexempel.
”CPU + Neural Engine tillåtet” betyder Core ML-inställningen CPU_AND_NE;
den visar inte var varje operation faktiskt kördes. En KiB är 1 024 byte.
Paketet på 787 KiB är fortfarande ett användbart resultat. Upplägget med åtta bitar komprimerar vikter med en palett på 256 värden, medan beräkningarna fortsatt görs i float16. Med CPU och Neural Engine tillåtna behåller det samma avrundade andel rätt som float16-paketet, även om 13 beslut skiljer sig från PyTorch-referensen. ”Samma resultat” är inte ”samma svar”.12
I den tidigare tidsmätningen på M4 var mediantiden per prediktion 1,314 ms,
med 1,411 ms vid den 95:e percentilen, för den konfigurationen. Mätningen
omfattar MLModel.predict över 29 836 beslut efter tre uppvärmningsexempel,
utan kodning av indata eller inläsning av modellen. Det är inte tiden för att
hantera ett helt formulär. Som jämförelse var float16-paketets median med enbart
CPU 1,727 ms i samma uppställning.13
Det mindre paketet ändrade vår tolkning av experimentet. Först utvärderade vi det med CPU och Neural Engine aktiverade, och andelen rätt föll till 49,92 %. Det såg ut som om fyrabitarsvikterna hade förlorat för mycket information. Men samma paket nådde 99,27 % på CPU, med bara 32 ändrade val jämfört med PyTorch. De avrundade vikterna klarade fortfarande uppgiften. Den mycket större försämringen berodde på hur den exporterade modellen kördes.
Vi kontrollerade de publicerade paketen på en annan dator, en M1 Max, med 512 beslut valda över hela testmängden. Int4 fick 511 rätt på CPU och 266 med CPU och Neural Engine aktiverade. När vi packade upp de komprimerade vikterna till vanliga flyttalskonstanter och behöll de redan avrundade värdena blev valen exakt desamma för respektive inställning. Det löste inte problemet.14
Den exakta orsaken är fortfarande okänd. Körningen gav meddelanden med
ANECCompile() FAILED, men varken meddelandena eller prediktionerna talar om
vilka operationer som kördes var. Det finns också en exportskillnad att
undersöka: float16 och int8 har iOS 17 som lägsta målversion, medan int4 har
iOS 18. Att matcha målversionerna och granska de resulterande graferna är ett
mer användbart nästa steg än att träna om för att kompensera för en oförklarad
skillnad vid körning.
Bakom det lilla paketet finns ytterligare en begränsning: den exporterade modellen tar emot 224 UTF-8-byte kontext, 96 byte per alternativ och högst 40 alternativ. Det är byte, inte ord eller tecken. Långa etiketter och tecken som tar flera byte använder utrymmet, och för lång text kapas. Verktygspaketet avvisar listor som överskrider det fasta taket i stället för att tyst släppa alternativ.15
Storlek, svarstid och andel rätt hör till ett visst indataformat och en viss körkonfiguration. Att testa modellvikterna räcker inte för att testa hela den kombinationen.
Granska mätverktygen också
Arbetet avslöjade också två fel i våra generatorer för syntetiska identifieringsnummer. Värdenas format var fel. Olika format kan ge en modell en oavsiktlig genväg: känn igen skiljetecknen och siffermönstret i stället för fältets betydelse. Tester kontrollerar nu de avsedda formaten och kontrollsiffrorna, och den publicerade modellen använder den korrigerade generatorn.6
En tidig omträning gav lägre resultat efter rättningen. Det var frestande att förklara hela tappet med att genvägen hade försvunnit. De senare, större körningarna gjorde den berättelsen mindre övertygande. Ingen av jämförelserna isolerar orsaken: de genererade exemplen och testmängderna ändrades, och de större körningarna fick fler träningsuppdateringar. En granskning av formaten visar en möjlig genväg; den mäter inte hur mycket modellen använde den.
Exporten behöver sina egna mätverktyg. Före konverteringen jämför verktygspaketet en exportanpassad PyTorch-implementation med dess spårade graf på 512 exempel. Sedan jämför det Core ML-besluten med PyTorch på utvärderingsdata. De kontrollerna svarar på olika frågor: om spårningen bevarar implementationen och hur mycket det exporterade paketet ändrar svaren.12
Sammantaget är de användbara kontrollerna ganska vardagliga: granska genererade data, räkna misstag per åtgärd, byt plats på kontexterna, jämför svar efter export och prova indata som inte kom från generatorn. Fixturfelet lägger till en sak: läs koden som avgör vad ”rätt” betyder.
Prova de publicerade modellvikterna
Verktygspaketet, modellen och Core ML-paketen och den syntetiska datamängden är publika. Datamängdens manifest anger uppdelningens storlekar och filernas hashvärden.
Använd den här versionen för att undersöka de två formulärfixturerna utan att göra om träningen. Kommandona nedan har kontrollerats med Python 3.12 och PyTorch 2.7.0 på macOS; fixturutvärderingen körs på CPU.
git clone https://github.com/precisit/one-pass-specialists
cd one-pass-specialists
git checkout 6a6def7887ea13a323049a972409b19aed953559

uv venv --python 3.12
uv pip install --python .venv/bin/python -e '.[train,dev]' 'torch==2.7.0' huggingface-hub

.venv/bin/hf download precisit/one-pass-sv-forms sv0-forms.safetensors sv0-forms.json --revision 778ff920104b36800a9f028521ad958eedcb8b7a --local-dir runs/released
.venv/bin/python -m pytest -q
OMP_NUM_THREADS=2 .venv/bin/python examples/sv-forms/build_real_forms.py --checkpoint runs/released/sv0-forms.safetensors --out fixture-results.json
Alla 13 tester i verktygspaketet passerar på den här versionen. Fixturkörningen
återskapar 52,8 % och 77,3 %, med de begränsningar som beskrivits ovan. Den
skriver beslutsraderna och fixture-results.json, så att det går att granska ett
fält, dess alternativ och förväntat svar tillsammans. Att rätta en fixtur ändrar
experimentet; håll isär de gamla och de nya resultaten.
Slutsats: en liten modell behöver en tydlig uppgift
Vi började med en praktisk fråga: skulle en liten lokal modell kunna ta hand om rutinbeslut i formulär medan vanlig kod behöll kontrollen över arbetsflödet? Storleken och tidsmätningarna gör den rollen rimlig. Ett paket på 787 KiB kan poängsätta alternativen för ett element på omkring 1,3 ms i den uppmätta M4-konfigurationen, och den svenska träningen visar hur mycket en kompakt modell kan lära sig från en avgränsad katalog.
Modellen är inte redo att fylla i okända formulär utan tillsyn. De 99,29 procenten på syntetiska data täcker inte de missade ifyllnaderna och svaga åtgärdsvalen i våra webbplatsfixturer. Även fixturerna behöver rättas innan de kan vägleda fortsatt träning. Nästa steg är att rätta och granska facit, och sedan pröva om en bredare katalog hjälper på undanhållna exempel från den faktiska uppgiften.
Core ML-resultatet visar ytterligare en gräns. Fyrabitarsvikter behöll 99,27 % rätt på CPU, men samma paket gav helt andra svar med en annan körkonfiguration. En användbar lokal specialist behöver därför belägg både för de beslut den har lärt sig och för hur applikationen kommer att köra den.
För en applikation med fasta, kända fält kan uttryckliga mappningar fortfarande vara det bästa verktyget. Där etiketter och tillstånd varierar är det här en liten komponent värd att pröva: tillhandahåll de tillåtna valen, mät misstagen som spelar roll och låt kod sköta utförande och verifiering. Den publicerade katalogen och utvärderingsverktygen ger andra team en plats att börja det experimentet med sin egen uppgift.
Det lockande är det vardagsarbete någon skulle kunna slippa. En liten modell behöver inte förstå allt för att vara användbar. Den behöver klara sin del av jobbet.
Fotnoter
-
Publicerade utvärderingsresultat för PyTorch, med åtgärdsfördelning, handskrivna exempel och kontextkontrollen. Siffran 99,29 % är det rapporterade top-1-resultatet 0,9929 avrundat till procent. ↩ ↩2
-
Publik fixturbyggare och facitlogik samt fixturresultat. Kontrollerna med omkastad kontext ger 42,1 % för Kanslist och 64,0 % för Pratsam. Fixturerna behöver granskas innan de kan betraktas som trogna tester av webbplatsernas kontroller. ↩ ↩2
-
TypeSafes introduktion av System One-modeller och Jev, 15 september 2026. Vi jämför inte med Jevs träffsäkerhet eller svarstid här. ↩
-
Ursprungliga projekt: jevlike, Cua-S1:s källkod, Cuas formulärmodell och Laya. Se respektive projekts egen omfattning och licens. ↩
-
Verktygspaketet och tredjepartskoden. Cuas inkluderade källkod kommer från
9bbfa7d; attention-huvudets angivna ursprung är jevlike94f5fd1. ↩ -
Svensk begreppskatalog, generator och katalogtester. Generatorns tidigare beteende beskrivs i modellarkivets versionsanteckningar. ↩ ↩2
-
Publicerad jämförelse av tre datamängder och körningssammanfattning. Tiderna avser de ursprungliga träningskörningarna; vi har inte upprepat träningen för artikeln. ↩ ↩2
-
Den syntetiska datamängdens publicerade manifest. Den slutliga datamängden innehåller 10 000 genererade episoder, uppdelade på episodnivå mellan träning, validering och test. ↩
-
Publicerad modellkonfiguration och träningsmetadata. Deterministisk träning var avstängd; enbart slumpfrön garanterar inte en identisk omkörning. ↩
-
Engelsk modell utvärderad på de svenska raderna. Det råa resultatet är 0,20748. Den oförändrade engelska modellen får svenska åtgärdssträngar såväl som svenska fältetiketter. ↩
-
Jämförelse av CPU och CPU + NE på hela testmängden och mätskript. Angiven plattform: M4, macOS 26.6, coremltools 9.0. Alla 29 839 rader ingår. Core ML:s inställning för beräkningsenheter tillåter en uppsättning processorer; den rapporterar inte operationernas placering. ↩
-
Publicerad konverteringsmetadata. Åttabitarsupplägget använder en likformig palett per tensor; fyra bitar använder K-means med kanalgrupper om 32. Båda räknar i float16. Spårningskontrollen jämför den exportanpassade implementationen med dess spårade graf, inte bitidentisk likvärdighet med den ursprungliga forward-implementationen. ↩ ↩2
-
Publicerade utvärderingsresultat och tidsmätningar för Core ML och utvärderingsimplementation. Storlekarna är summan av paketfilernas byte, inte minnesåtgång vid körning. De ursprungliga tidsmätningarna gjordes på en Apple M4; uppföljningen på M1 Max mäter bara andelen rätt. ↩
-
Verifieringsresultat från M1 Max och reproduktionsskript, med artefakternas hashvärden, urvalsindex och enskilda prediktioner. macOS 26.5.1, coremltools 9.0, PyTorch 2.7.0. Det deterministiska urvalet på 512 rader är en diagnostisk kontroll, inte en ersättning för andelen rätt på hela testmängden. Apples verktyg för att packa upp vikter tar bort de 17 operationerna som expanderar paletter; det kör också konverteringspass och bevisar därför inte att grafen i övrigt är identisk. Det uppackade paketet behåller de avrundade vikterna och iOS 18 som målversion. ↩
-
Den gemensamma bytekodaren och indatagränserna. UTF-8-byte förskjuts med ett så att noll förblir utfyllnad. Textkapning och det fasta alternativtaket är delar av exportens gränssnitt. ↩