M6 Mac mini, första intrycket: lokal AI i två hastigheter
Vår M6 Mac mini kom på premiärdagen. I två lokala språkmodeller ökade hastigheten mer när prompten lästes in än när svaret skrevs. Vi jämför med vår M5 MacBook Air.

Kapitel
Det finns två välbekanta pauser när du ställer en fråga till en lokal språkmodell. Först väntar du medan den bearbetar din prompt (prefill). Sedan ser du svaret växa fram, några bitar i taget (decode). En snabbare dator kan korta båda väntetiderna, men inte nödvändigtvis lika mycket.
Vår M6 Mac mini kom den 22 september, den nya modellens första leveransdag. Vi hade ett prestandatest redo och körde två små språkmodeller genom det, från korta prompter till 32 768 token kontext.1
Frågan var praktisk: var sparar den nya datorn tid? En modell i en kodagent kan läsa källkod, skriva en ändring, köra tester och läsa resultaten innan den försöker igen. Både indata och utdata kan bli långa, och båda väntetiderna återkommer längs vägen. Om lokal AI ska hjälpa oss att bygga saker behöver vi förstå båda.
I våra första mätningar bearbetade minin prompten med 1,85 till 3,37 gånger så hög hastighet som vår M5 MacBook Air. Svaret genererades med 1,41 till 1,63 gånger så hög hastighet. Intervallen gäller två bestämda modeller och fem promptlängder, inte alla uppgifter datorerna kan utföra.2
Två väntetider bakom en hastighetssiffra
Ta Qwen3.5-4B med en prompt på 2 048 token. Token är de textbitar en modell arbetar med, ofta ord eller delar av ord. Vi bad den producera exakt 128 nya token på varje dator.
| Uppmätt fas | M5 Air | M6 mini |
|---|---|---|
| Läsa prompten | 10,95 s | 4,67 s |
| Nästa 127 token | 11,70 s | 7,82 s |
Det här är medelvärden av uppmätta tider. Den andra raden omfattar de 127 intervallen mellan 128 genererade token. Modellinläsning ingår inte, och tiderna kommer från vårt prestandatest, inte från en komplett chattapplikation.3
Att bearbeta den befintliga prompten kallas prefill. Modellen bygger upp sitt tillstånd utifrån texten som redan finns. Att generera fortsättningen kallas decode: varje ny token beror på det som kom före, inklusive den token som just producerades.
Prefill står för en stor del av den första väntetiden i experimentet. I en applikation kan tiden till den första synliga token också omfatta inläsning, tokenisering av text, kötid och annat arbete. Hastigheten under decode beskriver hur snabbt svaret fortsätter när genereringen väl har börjat. Ingen av siffrorna berättar ensam hur lång tid hela samspelet tar.
I det här Qwen-fallet bearbetade M6-minin prompten med 438,97 token per sekund, jämfört med 187,14 på vår Air. Under decode var hastigheterna 16,24 respektive 10,86 token per sekund. Hastigheten blev ungefär 2,35 gånger så hög för prefill och 1,50 gånger så hög för decode. En enda siffra skulle dölja vilken väntetid som blev kortare.
Vad förändrades mellan våra två Macar?
Vår mini har en M6 med 12 GPU-kärnor och 32 GB enhetligt minne. Jämförelsedatorn är en M5 MacBook Air med 10 GPU-kärnor och lika mycket minne. Vi använde samma modellpaket och fasta testindata på båda.45
Vi jämför två kompletta system. Kylningen och GPU-konfigurationerna skiljer sig åt, liksom de registrerade macOS-versionerna. Mätningarna kan inte säga hur stor del av förbättringen som kommer från var och en av skillnaderna. De visar vad som hände när just de här två datorerna körde samma test.
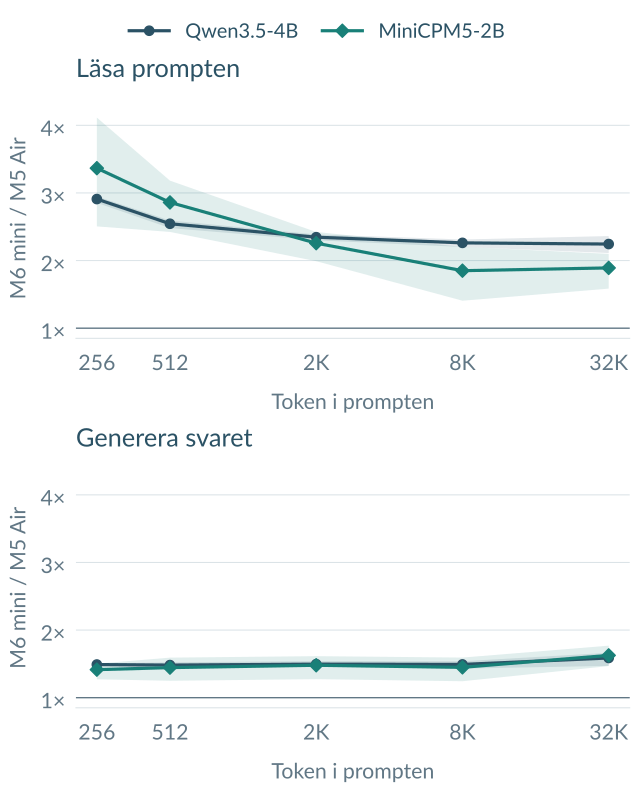
M6-minins hastighet delad med M5 Airs. Linjen vid 1× betyder samma hastighet. Båda diagrammen har samma lodräta skala. De skuggade banden visar beskrivande 95-procentiga intervall från bootstrap av mätomgångarna.
Punktskattningarna för prefill är högre än de för decode vid varje testad promptlängd. Hur stor skillnaden är varierar. Framför allt varierade MiniCPM5-2B:s prefill mycket mellan mätomgångarna på M5, vilket gör intervallet bredare. Den största kvoten, 3,37×, har ett intervall på ungefär 2,51× till 4,11×. Bandet är en del av resultatet.
Tre mätomgångar på en dator beskriver inte variationen mellan alla exemplar av den modellen. Intervallen hjälper oss att visa hur upprepbart vårt test var. De är ingen garanti för vad någon annans Mac kommer att prestera.
Över de här två modellerna och fem promptlängderna gav vår M6 mini 1,85–3,37 gånger så hög hastighet under prefill och 1,41–1,63 gånger så hög hastighet under decode som vår M5 Air.
En längre prompt förändrar bilden
Vi testade 256, 512, 2 048, 8 192 och 32 768 token i prompten och genererade alltid 128 token efteråt. Varje anrop började med en tom promptcache. Det håller jämförelsen inriktad på att bearbeta den givna kontexten, utan att ett tidigare anrop redan har gjort en del av arbetet.
De två modellerna var Q4-paket av MiniCPM5-2B och Qwen3.5-4B. Q4 syftar på fyrabitarskvantiserade vikter i paketet. Det betyder inte att varje värde eller operation använder fyra bitar. Den exakta konverteringen och vilket paket som används spelar roll när man ska återskapa resultaten.5
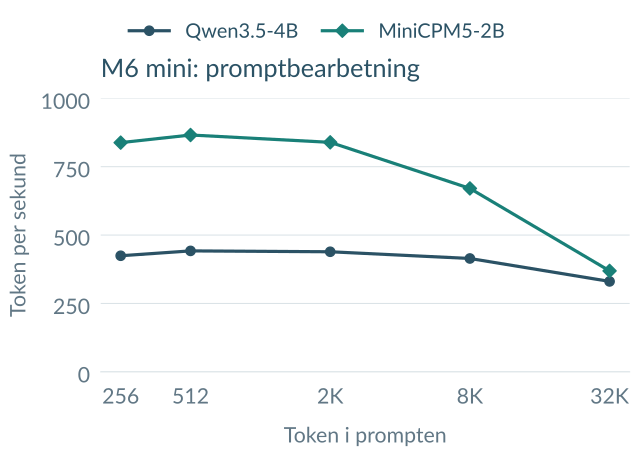
Promptbearbetning på M6-minin, ett anrop åt gången. Punkterna är medelvärden av tre mätomgångars medelvärden, med samma vikt för varje omgång. Varje modell har 12 uppmätta anrop per promptlängd, utom vid 32K där det finns sex. De smala skuggade intervallen finns med även där de är svåra att skilja från linjerna.
MiniCPM bearbetade korta prompter snabbare än Qwen i det här upplägget. Vid 32K låg hastigheterna närmare varandra: 369,04 respektive 330,53 token per sekund. Båda var lägre än vid 2K. Det finns mer text att bearbeta, och i de här mätningarna tar varje ytterligare token också längre tid i genomsnitt.
Även kurvorna för generering förändras med kontexten:
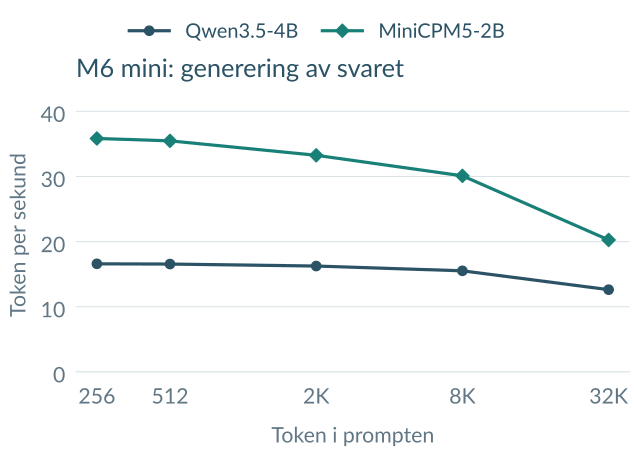
Hastighet under decode för 128 genererade token, mätt från den första till den sista. Produktionen av den första token ligger utanför intervallet; täljaren är de återstående 127. Antalet mätomgångar och upprepningar är samma som i prefill-diagrammet.
På M6 genererade båda modellerna token långsammare när prompten blev längre. MiniCPM:s hastighet under decode sjönk från 35,83 till 20,25 token per sekund mellan den kortaste och längsta prompten. Qwens sjönk från 16,58 till 12,62.6
Det är ett skäl att testa den kontext du faktiskt tänker använda. En kort chattprompt och en prompt som rymmer ett dokument kan ge olika intryck av samma modell på samma dator. Mätningarna isolerar inte bidragen från attention, cachetrafik, arkitektur eller val i körmiljön. Kurvorna kan därför inte peka ut en enda orsak.
De säger heller inget om vilken modell som ger det mest användbara svaret. Vi låste svarslängden för att mäta tid, inte för att bedöma svaren.
Skulle större block hjälpa?
Det minskande försprånget under prefill väckte en fråga: höll våra block på 2 048 token tillbaka M6? Blockstorleken styr hur mycket ny indata som bearbetas på en gång. Den tidigare kontexten finns kvar; ett block på 2K begränsar inte kontexten till 2K. Här betyder K 1 024 token.
Vi följde upp med ett separat prefill-experiment på båda datorerna. Prompten var hela tiden 32 768 token lång, och vi använde samma start- och slutpunkter för tidtagningen som tidigare. Här är M6-resultaten i token per sekund:7
| Blockstorlek | MiniCPM | Qwen |
|---|---|---|
| 2K | 369,0 | 328,3 |
| 4K | 373,3 | 315,5 |
| 8K | 372,7 | 282,9 |
| 16K | 367,4 | Buffertgräns |
| 32K | 359,0 | Buffertgräns |
MiniCPM var snabbast med block på 4K, bara 1,2 procent över experimentets 2K-baslinje. Qwen var snabbast vid 2K och blev långsammare när blocken växte. De två största blockstorlekarna misslyckades på båda datorerna: körmiljön begärde enskilda buffertar som var större än vad Metal tillät. Hela prompten på 32K fungerade fortfarande med mindre block.
I de slutförda huvudjämförelserna var M6 fortfarande ungefär 1,96–2,12 gånger så snabb som M5. Ett diagnostiskt test hoppade över mellanliggande beräkningar i modellens utdatahuvud, steget som omvandlar modelltillståndet till poäng för nästa token. Det gav inte heller något större relativt försprång. Större block återställde alltså inte den hastighetsvinst vi såg med korta prompter. Experimentet stöder 2K som en rimlig baslinje i det här upplägget, men lämnar orsaken till att kvoten förändras med kontextlängden öppen. De ursprungliga mätningarna och diagrammen ovan är oförändrade.
Så mätte vi
För den ursprungliga jämförelsen av kontextlängder använde vi ett mätverktyg kring oförändrad MLX och MLX-LM, med kontrollerade modellpaket och fasta token som indata. Miljön vid leveransen använde MLX 0.32.2 och mlx-lm 0.31.3. Mätverktyget beräknar hela prompten i block innan den första utdata-token väljs, och registrerar sedan när följande token genereras.8
| Inställning | Värde |
|---|---|
| Modeller | MiniCPM5-2B och Qwen3.5-4B, affin Q4, gruppstorlek 64 |
| Promptlängder | 256, 512, 2 048, 8 192, 32 768 token |
| Svarslängd | 128 token per anrop |
| Batchstorlek | 1 |
| KV-cache | 16 bitar |
| Blockstorlek för prompt | 2 048 token |
| Mätomgångar | 3 per dator |
| Uppmätta upprepningar | 4 per fall och omgång; 2 vid 32K |
| Uppvärmning | 1 per fall och omgång, ingår inte i resultaten |
Varje dator genomförde 108 uppmätta anrop och 30 uppvärmningsanrop. Varje hastighet i diagrammen är medelvärdet av de tre mätomgångarnas medelvärden, med samma vikt för varje omgång. Osäkerhetsbanden kommer från 10 000 bootstrap-omsamplingar av dessa medelvärden. Vid beräkningen av kvoterna samplas de två datorernas resultat om oberoende av varandra.8
Indata är fasta testfixturer med token, medan tiderna kommer från verkliga körningar. En upprepbar indatalängd hjälper oss att jämföra prestanda. Det gör inte försöket till ett test av dokumentförståelse eller svarskvalitet.
Vi kontrollerade också vägen från en registrerad händelse till en punkt i
diagrammet. För Qwen vid 2K på M6 läste vi tidsstämplarna för den första och
sista token i alla 12 uppmätta anrop och räknade om hastigheten under decode som
127 / (last_token_time - first_token_time), med tiden i sekunder. Medelvärden
inom omgångarna och sedan mellan dem gav samma 16,24 token per sekund som
i diagrammet. Det kontrollerar aritmetiken bakom punkten; det är ingen oberoende
omkörning av hårdvaruexperimentet.9
I underlaget (ZIP) finns mättabeller, utdrag ur tidtagningskoden och ett Python-skript som kontrollerar diagrammens medelvärden och kvoter utan nätverksanslutning.
Vad det första testet lämnar öppet
Det här är ett test med små modeller och ett anrop åt gången. Det fastställer inte prestandan för större modeller, flera samtidiga användare, återanvända prefix eller en komplett kodagent. Det förklarar inte heller vilken mekanism i hårdvaran som ligger bakom förbättringarna.
Vi undersöker separat FP8-körning genom Metal, Apples GPU-API. En första numerisk kontroll visar att den begärda programvaruvägen kan köras korrekt på systemet. Det visar inte att FP8 körs direkt i hårdvaran eller att det ger en prestandavinst. De frågorna behöver egna mätningar och belägg för hur beräkningen faktiskt utförs.10
Var en mini passar i ett agentflöde
En kod- eller terminalagent gör de två väntetiderna till en slinga. Källkod, instruktioner och verktygsresultat blir indata; resonemang, kod och verktygsanrop blir utdata. När arbetet växer kan kontexten göra det också. Våra svar på 128 token mäter en del av slingan. De berättar inte hur lång tid en större kodändring skulle ta, eller om modellen skulle lyckas med den.
Det finns en variabel till: hur mycket måste modellen läsa om? En körmiljö kan återanvända cachat tillstånd för ett oförändrat prefix. LM Studios egna tester visar varför det spelar roll: på samma M3 Max slutförde mlx-engine 1.8.5 ett upprepat anrop med en bildprompt ungefär 3,5 gånger så snabbt som version 1.7.0, efter förbättrad återanvändning av cachen. Det är en jämförelse av programvaruversioner med en annan uppgift och dator än vår. Men den påminner om att programvaran kan förändra väntetiden mellan turerna. Våra tester med tom cache lämnar den frågan öppen.11
För krävande lokal kodning förtjänar minneskapacitet och bandbredd var sin granskning. Modell, kontextcache och arbetsbuffertar behöver plats vid sidan av editorn och andra verktyg. Högre bandbredd kan hjälpa genereringen när det är dataförflyttning som begränsar hastigheten, men modell och körmiljö spelar fortfarande roll.12 JetBrains nuvarande Junie Local-upplägg anger exempelvis minst 64 GB RAM för den valda modellen Qwen3.6-27B, mer än vår minis 32 GB. Det är ett krav i just det upplägget, inte ett minimum för all lokal kodning.13 En större kodbas behöver inte rymmas i prompten i sin helhet. Vad agenten väljer ut och behåller spelar också roll.
En mini som alltid är på kan också ha ett mer avgränsat jobb: hjälpa till att sortera inkommande e-post, skriva svarsförslag, söka i dokument eller samordna verktyg. Att köra agenten lokalt kräver inte att alla modeller körs på samma dator. OpenClaw kopplar exempelvis meddelandetjänster till agenter som använder lokala modeller eller molnmodeller, och stöder lokala embeddings för sökning i minnet.1415 MLX-Audio erbjuder lokal taligenkänning och talsyntes på Apple Silicon.16 Det gör ett hybridupplägg möjligt: sökning, tal till text och text till tal på minin, med en molnmodell för mer krävande kodning eller resonemang. Text som skickas till det API:et lämnar fortfarande datorn.
Det gör minin intressant både för experiment med små modeller och som värd för utvalda delar av ett större system. Vi har mätt de två textmodellerna i den här artikeln, inte dessa agent- eller ljudflöden.
Slutsats: mät väntetiden som spelar roll
Våra första M6 mini-resultat visar förbättringar i båda faserna av lokal inferens jämfört med den M5 Air vi testade. Promptbearbetningen vann mer i punktskattningarna, medan svaret genererades med en mindre hastighetsökning. Längre prompter förändrade både den absoluta hastigheten och jämförelsen.
För en agent är nästa användbara mätning en färdig uppgift: läsa relevanta filer, göra en ändring, kontrollera den och rätta till misstag. Mät lång kontext och uthållig generering tillsammans, med cachepolicy och modell tydligt angivna. Ta med om resultatet är korrekt. Snabbare token hjälper bara om de för arbetet framåt.
Resultaten ger oss en utgångspunkt för mindre lokala modeller och avgränsade uppgifter. Större modeller, längre sparad kontext eller flera agenter kan kräva mer minne och högre bandbredd. Ett hybridupplägg erbjuder en annan väg: behåll användbara delar på minin och låt en molnmodell ta hand om det som överskrider dess lokala kapacitet.
I vårt Qwen-exempel vid 2K sjönk väntetiden för promptbearbetningen från nästan elva sekunder till under fem. Orden som följde kom också snabbare, men med en annan marginal. Nästa fråga är hur mycket av den sparade tiden som når någon som väntar på en fungerande ändring, ett användbart svar eller en färdig uppgift.
Fotnoter
-
Apple, Mac mini med M6 och M5 Pro. Presenterades den 25 augusti 2026; leveranser till kunder började den 22 september. ↩
-
Precisit, frysta jämförelsedata för M6/M5, F13. ↩
-
Medeltider omräknade från registrerade Qwen-anrop vid 2K för M6-körningen och M5-kontrollen. Det är medelvärden av tider, inte inverser av medelhastigheter. ↩
-
Datoruppgifter för M6 Mac mini och M5 MacBook Air. Båda rapporterar 32 GiB RAM och avstängt strömsparläge. macOS-byggena är
26A428respektive26A5388g. Minin hade ingen ansluten skärm, medan Air-datorn rapporterade en. ↩ -
Verifiering av modellpaketen. Q4-matriser som stöds bevarar källpaketets representationer. Qwen-paketet innehåller 24 Conv1d-anpassningar för kompatibilitet som materialiserar de representerade värdena. De här kontrollerade paketen ska inte antas vara likvärdiga med valfri annan Q4-nedladdning. ↩ ↩2
-
Absoluta hastigheter och tider för M6: prefill, F05 och decode, F06. Artikelns diagram genereras från dessa filer och F13, med de registrerade intervallen bevarade. ↩
-
Precisit, matchat experiment med blockstorlekar vid 32K och upplägg för uppföljningen, 23 september 2026. Samma modellpaket, indata och 16-bitars KV-cache på båda datorerna. Tre mätomgångar, två uppmätta upprepningar per huvudfall och en per diagnostiskt fall i varje omgång. Diagnostiken omfattar ändpunkterna 2K och 32K. Alla slutförda fall behöll samma slutliga top-1-token jämfört med respektive dators 2K-referens. Det största absoluta felet i slutliga logits var ungefär 0,000113. Qwens misslyckade konfigurationer begärde enskilda buffertar på 32 respektive 64 GiB, mot en gräns per buffert på cirka 20,1 GB. Detta är ett separat prefill-experiment, inte en ersättning för den ursprungliga jämförelsen av kontextlängder eller en utvärdering av svarskvalitet. ↩
-
Kod för tidtagning och analys, experimentets inställningar och registrerade programvaruversioner. Modellinläsning ligger utanför tidtagningen. Policyn för hela prompten heter
full_prompt_last_logits_v2. ↩ ↩2 -
Oberoende omräkning av Qwens decode-resultat vid 2K. Medelvärdet är 16,24401238410306 token per sekund, exakt samma som i F06. Det räknades också om under artikelgranskningen. ↩
-
Sammanfattning av den numeriska FP8-kontrollen vid leveransen anger
native_fp8_attribution: unknownochmeasured_benefit: false. ↩ -
LM Studio, Improving LM Studio's MLX Engine for Agentic Workflows, 5 juni 2026. Jämförelsen använder en upprepad bildprompt med Qwen3.6-27B-MLX-4bit på en M3 Max med 36 GB RAM. Det andra anropet tar 23,79 s med mlx-engine 1.7.0 och 6,88 s med 1.8.5, som återställer större delen av den cachade prompten. Det är en jämförelse av applikationens körmiljö, inte en jämförelse med våra M6-mätningar. ↩
-
Tom's Hardware, inferensmätningar på M4 Max med Apple Silicon, 30 juli 2026. Det uppmätta försprånget vid generering gentemot andra system med enhetligt minne varierar mellan tre modellarkitekturer, trots samma bandbreddsfördel i hårdvaran. Annan hårdvara, andra modeller och annan körmiljö gör detta till bakgrund för tolkning av specifikationer, inte en verifiering av våra hastighetsvinster. ↩
-
JetBrains, förutsättningar för Junie Local, läst den 23 september 2026. Det dokumenterade upplägget använder Qwen3.6-27B-4bit med en utkastmodell för spekulativ avkodning och kräver Apple Silicon M5 eller senare samt minst 64 GB RAM. ↩
-
OpenClaw, What is OpenClaw? och var data lagras. Agentens gateway kan köras lokalt medan anrop går till en extern modellleverantör. ↩
-
OpenClaw, översikt över minnessökning. Bland alternativen för embeddings finns lokal GGUF, Ollama och LM Studio samt externa API:er. ↩
-
MLX-Audio, projektets dokumentation för taligenkänning och talsyntes på Apple Silicon. Funktionerna dokumenteras där; prestandan på vår mini har inte mätts i det här experimentet. ↩