Färre experter, snabbare svar på en Mac?
En ändring på en rad får MoE-modeller att generera snabbare på Apple silicon. Vi testade Qwen3 och DeepSeek med bf16 och 4-bitarsvikter: båda blev snabbare, men svarens kvalitet påverkades olika.

Kapitel
När en lokal assistent skriver ett svar kan några fler token per sekund göra väntan kortare. Men om ett snabbare svar behöver rättas kanske den sparade tiden bara flyttas från datorn till dig.
En ny forskningsartikel föreslog en lockande justering: låt en Mixture-of-Experts-modell rådfråga färre experter för varje token. Ingen omträning, ingen ny modell att ladda ned. Ändra bara hur många av modellens befintliga experter som deltar. Chen och kollegor rapporterade att ungefär 99 % av den utvärderade kvaliteten behölls i genomsnitt, med snabbare generering för de fyra modeller och två inferensramverk där de mätte tiden.1
Vi provade idén i MLX på Apple silicon med Qwen3-30B-A3B och DeepSeek-V2-Lite-Chat. Båda blev snabbare. Med 4-bitarsvikter och en förfrågan åt gången ökade den första minskningen antalet genererade token per sekund med ungefär 8 % för Qwen3 och 11 % för DeepSeek på vår M5 Max. Men svaren skilde sig åt: Qwen3 hade ingen statistiskt påvisbar försämring på vårt fullständiga matematiktest med den inställningen. DeepSeek tappade ungefär fyra procentenheter.
Den egentliga frågan blev: hur mycket arbete kan vi hoppa över innan svaret slutar vara värt den kortare väntan?
Vad en expert gör
I en Mixture-of-Experts-modell, eller MoE-modell, innehåller vissa lager en samling små neurala nätverk som kallas experter. En router poängsätter dem för varje token och väljer ut några. Deras resultat viktas och kombineras innan beräkningen fortsätter. ”Expert” är ett namn på en inlärd komponent, inte ett löfte om att en kan astronomi och en annan skriver bra SQL.
Qwen3-30B-A3B har 128 routade experter per MoE-lager och väljer normalt åtta för varje token. Vi bad modellen använda sex, sedan fem. DeepSeek-V2-Lite-Chat väljer normalt sex av 64 routade experter. Där provade vi fyra, sedan tre. Dess två delade experter är fortfarande aktiva.
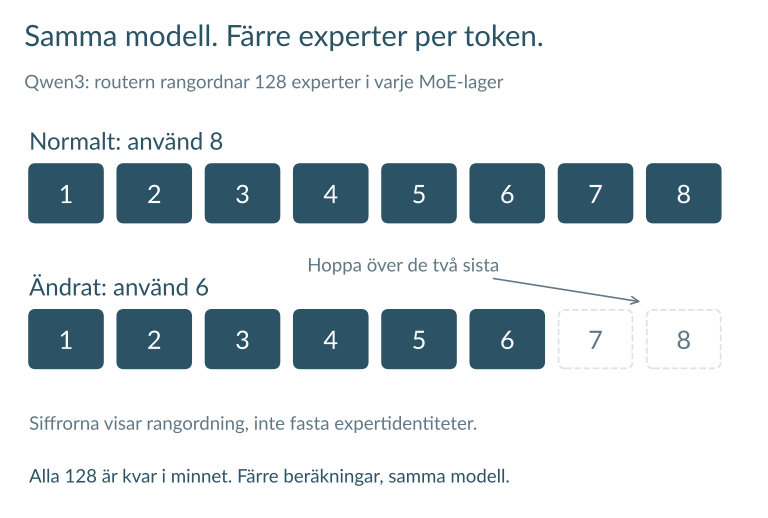
Forskningsartikelns första inställning behåller två tredjedelar av det vanliga urvalet, avrundat uppåt. Qwen3:s ändring från åtta till sex blir därför en minskning med 25 %, medan DeepSeeks ändring från sex till fyra tar bort en tredjedel. Routern väljer fortfarande vilka experter som ska användas för varje token.
Det här skiljer sig från samplingsinställningen top-k, som används för att välja nästa token i svaret. Här ändrar vi själva beräkningen som ger dessa tokensannolikheter. Alla expertvikter finns kvar i minnet. Modellen blir alltså inte mindre, och inget minne frigörs.
Vad som förändrades på våra Macar
Vi testade modellerna med bf16, ett 16-bitars flyttalsformat, och med vikter kvantiserade till 4 bitar. Huvudjämförelserna nedan kommer från en obelastad M5 Max med 128 GB enhetligt minne, MLX 0.32.3 och mlx-lm 0.32.0. Vi gjorde också kompletterande tester på en M5 Pro och en M1 Max.2
För varje hastighetsjämförelse använde vi sex nystartade processer per inställning och varvade inställningarna i stället för att köra alla baslinjemätningar först. Testet med en förfrågan genererade 512 token från en prompt på 944 token. Ett separat test med åtta samtidiga förfrågningar använde kortare promptar och genererade 256 token per förfrågan. Inom varje jämförelse var indata och svarslängderna fasta.
Resultaten med en förfrågan visar avvägningen tydligast:
| Modell | Vikter | Experter | Före | Efter | Ökning |
|---|---|---|---|---|---|
| Qwen3 | bf16 | 8 → 6 | 70,3 | 79,0 | 12,3 % |
| Qwen3 | 4 bitar | 8 → 6 | 144,4 | 155,6 | 7,8 % |
| DeepSeek | bf16 | 6 → 4 | 90,6 | 105,2 | 16,1 % |
| DeepSeek | Vår 4-bitarskonvertering | 6 → 4 | 194,3 | 215,2 | 10,8 % |
Före och efter anger genererade token per sekund på M5 Max. ”Ökning” avser antalet token per sekund, inte den procentuella minskningen av tidsåtgången.
4-bitarsmodellerna var redan betydligt snabbare i absoluta tal, men vann mindre på att hoppa över experter. Det är två olika jämförelser. En mindre procentuell förbättring betyder inte att bf16 är det snabbaste sättet att köra modellen.
Räkna byte, mät sedan
När en GPU genererar en token i taget får den ofta vänta på att vikter ska hämtas från minnet. Apple beskriver denna begränsning av minnesbandbredden i sitt arbete med MLX-inferens.3 Om färre experter deltar behöver färre expertvikter läsas. Det ger ett sätt att uppskatta utrymmet för förbättring.
Anta att de routade experterna står för andelen av alla byte som läses i ett steg, och att vi behåller andelen av dessa experter. Om allt annat är oförändrat blir den återstående datamängden proportionell mot:
Om tiden vore proportionell mot datamängden skulle hastighetsfaktorn vara inversen av uttrycket. Om experterna exempelvis står för 56 % av alla byte ger sex i stället för åtta experter , alltså ungefär 1,16 gånger så många token per sekund. Att ta bort en fjärdedel av experterna har inte tagit bort en fjärdedel av hela steget.
Vi beräknade tensorernas lagringsutrymme från viktfilernas headers och kvantiseringsformat, inklusive kvantiseringens metadata.4 De routade experterna stod för ungefär 53–58 % av den beräknade datamängden per steg för de två modellerna och precisionsnivåerna. Vår första förklaring hade varit att 4-bitarsvikter måste lämna en betydligt mindre expertandel att ta bort. Vår egen beräkning uteslöt den förklaringen.
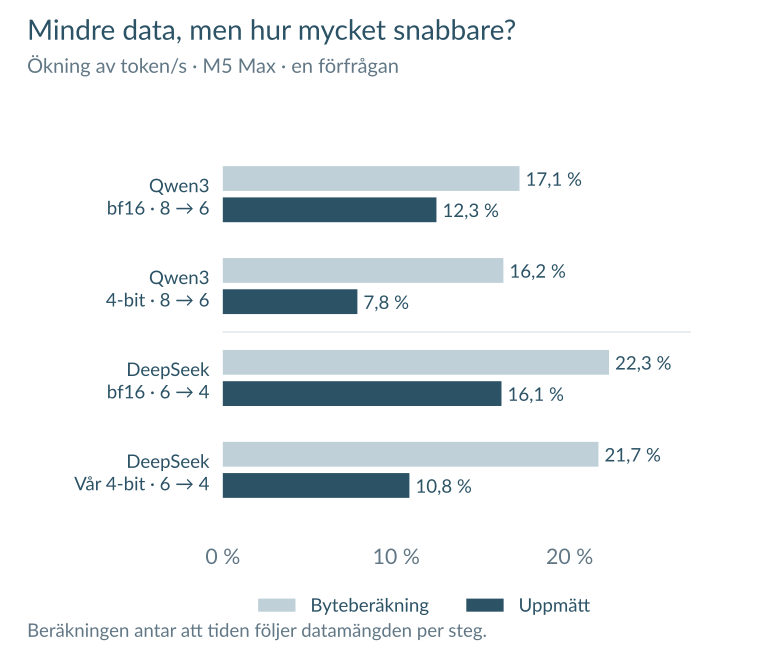
För minskningarna i figuren uppnådde bf16 ungefär 72 % av förbättringen som byteberäkningen antydde. 4-bitarsmodellerna nådde ungefär 48–50 %. De större minskningarna gav ett liknande mönster vid batchstorlek ett: runt 70 % för bf16 och ungefär hälften för 4 bitar.
Skillnaden spelar roll när man bedömer en uppskattning. En uppmätt hastighetsfaktor på 1,08 ligger nära en uppskattad faktor på 1,16 om vi dividerar dem med varandra. Men förbättringen är åtta procentenheter i stället för sexton: ungefär hälften så stor ökning av antalet token per sekund. Vi använde först den förra jämförelsen och fick uppskattningen att se mer träffsäker ut än den var.
Byteberäkningen beskriver en möjlighet under ett antagande, inte en prognos eller ett allmängiltigt tak. Med åtta samtidiga förfrågningar överträffade Qwen3 bf16 faktiskt uppskattningen och nådde 144–184 % av den beräknade förbättringen för sina två minskningar. DeepSeek upprepade inte det resultatet.
Vid batchstorlek åtta antar beräkningen dessutom att förfrågningarna väljer experter oberoende av varandra och med jämn fördelning. Verkliga förfrågningar kan dela fler experter än antagandet medger, vilket gör datamängden som bara behöver läsas en gång svårare att uppskatta. Vi fastställde inte hur mycket detta förklarar av skillnaden. Testet med åtta förfrågningar använde dessutom andra prompt- och svarslängder. Det är därför en annan arbetslast, inte ett test där enbart batchstorleken ändrades.
Varför får 4-bitarsmodellerna ut mindre av den uppskattade vinsten? Uppackning av kvantiserade vikter, start av GPU-kernels och annat arbete per steg är möjliga bidragande orsaker. Vi profilerade inte deras enskilda kostnader, så mätningarna avgör inte vilken förklaring som väger tyngst. De visar däremot att vi inte bör föra över en procentuell bf16-vinst till en 4-bitarsmodell utan att mäta.
Snabbare, men på vad?
För att testa kvaliteten använde vi alla 1 319 uppgifter i matematiktestet GSM8K, med greedy-avkodning. Varje reducerad inställning besvarade samma uppgifter som sin egen baslinje. Jämförelsen är parad: den följer vilka enskilda svar som ändrades, inte bara två oberoende totalresultat.
Qwen3:s andel rätt med bf16 gick från 94,09 % med åtta experter till 93,48 % med sex. Det är en minskning med 0,61 procentenheter. Det parade 95-procentiga konfidensintervallet sträckte sig från en förlust på 1,67 procentenheter till en vinst på 0,38. Förändringen med 4-bitarsvikter var mindre: minus 0,15 procentenheter, med ett intervall från minus 1,14 till plus 0,83.
Intervallen innehåller noll, men också försämringar. ”Ingen statistiskt påvisbar försämring” slår inte fast att svaren är likvärdiga.
DeepSeeks andel rätt med bf16 föll från 69,67 % med sex experter till 65,50 % med fyra, en förlust på 4,17 procentenheter. Konfidensintervallet låg helt under noll. Att ta bort ytterligare en expert ökade tappet.
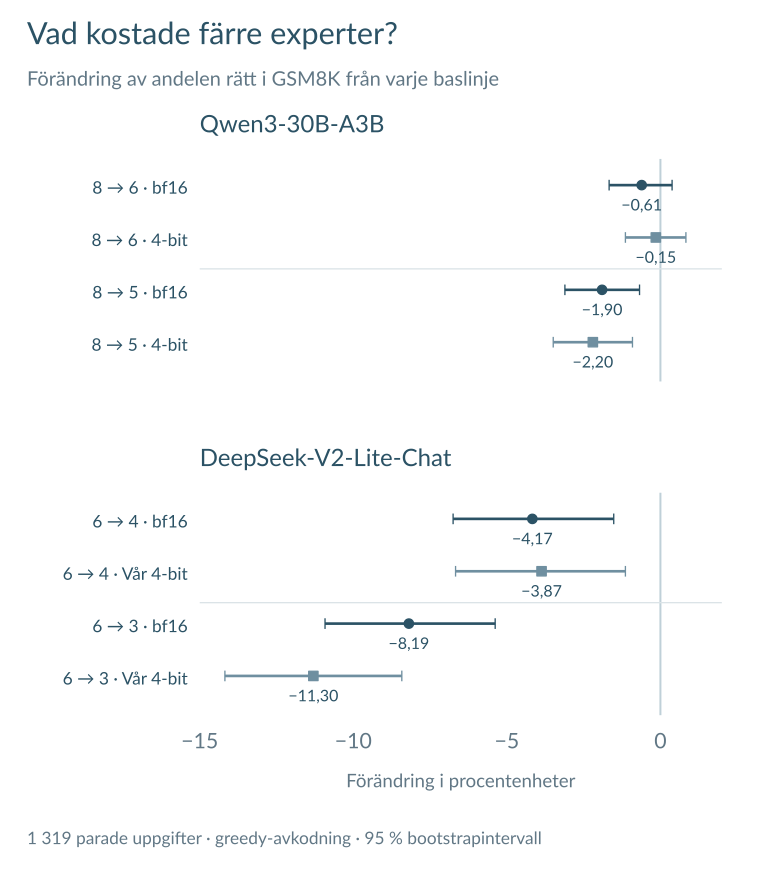
Samma regel för att välja färre experter gav olika kvalitetsförluster i de två modellerna. Qwen3 klarade den första minskningen bättre än DeepSeek på det här testet. Inget av resultaten ger oss en generell inställning för lokala modeller.
Det finns en skillnad i implementationen som är värd att undersöka. Qwen3 normaliserar om routervikterna efter att de kvarvarande experterna valts ut. DeepSeek-V2-Lite gör inte det, så när experter tas bort minskar också den sammanlagda vikten av deras bidrag. Det kan spela roll, men vi gjorde inte experimentet som skulle behövas för att fastställa det som orsaken.
Forskningsartikelns resultat ger en användbar jämförelse. I artikeln fick Qwen3-30B-A3B-Instruct 94,4 % rätt på GSM8K med åtta experter och 95,0 % med sex. Resultatet för DeepSeek-V2-Lite-Chat föll från 63,1 % till 61,7 % med sex respektive fyra experter: en förlust på 1,4 procentenheter, jämfört med våra 4,2 med bf16.1
Vår Qwen3-version var den ursprungliga hybridmodellen, med thinking-läget avstängt, i stället för artikelns Instruct-version. Även DeepSeeks promptar, avkodning och sättet att extrahera svar skilde sig åt. Vi testar hur idén fungerar i vår miljö, utan att återskapa varje publicerat testvillkor identiskt.
Kontrollera baslinjen innan du ändrar den
Vårt första kvalitetstest gav ett mindre uppmuntrande svar för Qwen3 med 4-bitarsvikter. Vi använde 200 uppgifter, samplad generering med fem slumpfrön, batchstorlek ett och en M1 Max. Sex experter tappade 1,5 procentenheter och klarade inte gränsen vi hade satt före testet.
Det senare, fullständiga testet reproducerade inte tappet. Men vi hade ändrat samplingsmetod, batchstorlek och dator utöver antalet frågor. Vi kan inte tillskriva det annorlunda resultatet enbart ett större urval. Det första testet är fortfarande underkänt enligt sina ursprungliga regler.
DeepSeek synliggjorde ett separat problem. Vår egen 4-bitarskonvertering hade
redan tappat ungefär 9,9 procentenheter på GSM8K innan vi tog bort en enda
expert. Den gav också formateringsproblem som gjorde jämförelserna på kodtestet
oanvändbara. Qwen3:s 4-bitarsbaslinje, en konvertering från mlx-community,
tappade ungefär 1,1 procentenheter på GSM8K, en betydligt mindre förändring.
DeepSeek-jämförelserna visar fortfarande vad färre experter gjorde inom den konverteringen. De beskriver inte alla 4-bitarsversioner av DeepSeek. Validera modellen du laddat ned eller konverterat innan du testar en optimering ovanpå den. Annars blir det svårt att skilja de två felkällorna åt.
Vi testade också kodgenerering med HumanEval. Dess 164 uppgifter gav breda intervall, och formateringsproblemen med DeepSeek i 4 bitar begränsade vad vi kunde dra för slutsatser. Ett resultat på matematikuppgifter ersätter inte tester av koden, dokumenten eller samtalen du faktiskt behöver.
Token per sekund är inte tid till ett användbart svar
Testerna med fast svarslängd isolerar genereringshastigheten, men en modell kan ändra hur mycket den skriver när beräkningen ändras. Med de reducerade inställningarna genererade våra modeller ungefär 2–11 % fler token på GSM8K.
Ta Qwen3 med 4-bitarsvikter och åtta respektive sex experter:
| Mätning | Förändring |
|---|---|
| Token per sekund med fast svarslängd och batchstorlek åtta | 12,8 % fler |
| Tid att generera samma mängd text, beräknad från den kvoten | 11,4 % kortare |
| Genererade token i hela GSM8K-körningen | 5,2 % fler |
| Tidsåtgång för hela GSM8K-körningen | 8,3 % kortare |
Den andra raden använder inversen: . De två sista raderna kommer från en annan arbetslast, med varierande svarslängder, promptbearbetning och batchar där färdiga rader får vänta. Varje kvalitetsinställning hade en fullständig körning, så tidsåtgången är en indikation snarare än ett resultat från upprepade tidmätningar.
Längre svar kan rimligen förklara en del av skillnaden, men vi skilde inte deras effekt från de andra förändringarna i körningen. Det viktiga för en lokal assistent syns ändå: en snabbare ström av token är bara en del av att bli färdig med arbetet tidigare.
Prova inställningen i MLX
Med mlx-lm 0.32.0 kan modellkonfigurationen ändra antalet utvalda experter vid inläsning.5 För den Qwen3-version vi testade ser ändringen ut så här:
from mlx_lm import load

model, tokenizer = load(
    "path/to/your/qwen3-model",
    model_config={"num_experts_per_tok": 6},
)
Modellens normala inställning är åtta. Det här ändrar routingen utan att träna om modellen eller skriva om viktfilerna. Använd separata, nystartade processer för baslinjen och den ändrade inställningen. Behåll samma modellfiler, prompt, genereringsinställningar och gräns för svarslängden när du mäter tiden.
Testa sedan riktiga uppgifter också. Spara svaren, jämför dem uppgift för uppgift och notera hur mycket modellen genererade. En obelastad dator spelar roll: vår upptagna M1 Max kunde inte tydligt urskilja den lilla hastighetsvinsten enligt protokollets regel för mätbrus, medan de obelastade datorerna kunde det.
Mätningarna här omfattar två modeller, korta promptar och kontrollerade tester. De fastställer inte kvaliteten för kodagenter med lång kontext eller öppna samtal. Det praktiska experimentet är litet nog att prova. Vilka belägg som behövs för att behålla inställningen beror på arbetet den ska användas till.
Läs hela den tekniska rapporten på engelska (PDF, 10 sidor, 294 kB) för metoder, fullständiga resultat och begränsningar. I repot för att återskapa testerna finns protokollet, körbar kod och underlaget för de enskilda mätningarna.
Slutsats: färre experter, fortfarande användbara svar
Att minska antalet experter fungerade som en hastighetsjustering i MLX. På vår M5 Max gjorde den första minskningen genereringen med 4-bitarsvikter och en förfrågan åt gången ungefär 8–11 % snabbare. Qwen3:s fullständiga matematiktest visade ingen statistiskt påvisbar försämring vid den inställningen. DeepSeeks visade ett tapp på ungefär fyra procentenheter.
Att räkna byte hjälpte oss att se vilket arbete som kunde försvinna. Att mäta visade hur mycket snabbare det faktiskt gick. Att läsa och bedöma svaren avgjorde om hastigheten var användbar. Inget av stegen kunde ersätta nästa.
För den som bygger en lokal assistent är det här en inställning värd att experimentera med, inte något att avfärda på förhand. Behåll den om dina egna uppgifter visar att avvägningen håller. Målet är inte att rådfråga så få experter som möjligt. Det är att vänta kortare på ett svar du kan använda.
Fotnoter
-
Chen med flera, You Only Need 2/3 of the Chosen Experts: An Empirical Study of Dynamic Expert Pruning in Fine-Grained MoE LLMs, september 2026. Den genomsnittliga bibehållna kvaliteten beskriver deras utvärdering, inte varje modell eller uppgift. Se artikeln för modellversioner och inställningar för utvärdering och inferens. ↩ ↩2
-
Magnus Lundstedt, Fewer Experts per Token on Apple Silicon: Speed Opportunity, Realised Speedup and Quality Cost, oktober 2026. Se rapporten ovan och protokoll och mätningar vid
report-2026-10, commit902fb96. De parade GSM8K-intervallen använder 10 000 bootstrap-omdragningar. ↩ -
Apple Machine Learning Research, Exploring LLMs with MLX and the Neural Accelerators in the M5 GPU, november 2025. ↩
-
För vår egen 4-bitarskonvertering av DeepSeek beräknade vi lagringen från bf16-filernas headers med 4,5 bitar per vikt för matriser som kvantiseras av mlx-lm, medan övriga delar behöll bf16. Den konverterade modellen hade totalt 4,503 bitar per vikt. Se avsnitt 3.5 i den tekniska rapporten. ↩
-
Inläsaren i mlx-lm 0.32.0 tar emot
model_config. Värdena slås samman med modellens sparade konfiguration innan modellen skapas. ↩