En AI-motståndare på 1,6 MB
Träning med ternära vikter (bara tre värden) gav en ny modell på 1,6 MB. Vi jämförde packningsformaten Base243 och T34: att träna och att konvertera gav olika resultat.

Kapitel
Innan en AI kan göra sitt första drag i webbläsaren måste den ta sig dit. Ett snabbt beslut är användbart när modellen väl körs, men spelaren måste först ladda ned alla tal som gör beslutet möjligt.
I vårt första experiment med fyra i rad tränade vi en liten modell som läser brädet, poängsätter de tillåtna kolumnerna och väljer ett drag i ett enda framåtpass, utan att söka igenom framtida ställningar. Dess int8-modellfil var 7,8 MB. I uppföljningen gjorde vi körmiljön mindre och snabbare. Då blev vikterna nästa naturliga fråga: hur mycket kunde vi ta bort från nedladdningen innan motståndaren glömde hur man spelar?
En ny modell med samma arkitektur och träningsdata ryms i 1,59 MB och behåller en liknande spelstyrka i våra tester. De flesta av dess vikter är ternära: −1, 0 och +1, multiplicerade med en gemensam skalfaktor. Att träna med den begränsningen fungerade. Att lägga den på den färdiga modellen gick betydligt sämre.1
Med en längre sista träningsetapp nådde T34-modellen 93,0 % mot en bot som söker fyra drag framåt och 91,0 % mot en som söker sex drag, med oavgjort räknat som en halv vinst. På ställningar som inte användes i träningen bevarade 98,9 % av modellens drag spelets exakta utfall, jämfört med 98,7 % för den ursprungliga fp32-modellen. Att upprepa träningen hjälpte oss att sätta resultaten i perspektiv.
Skillnaden är användbar även utanför spelet: ett lagringsformat kan vara något modellen lär sig att leva med, i stället för något den påtvingas när inlärningen är klar.
Varför använda ett spel som måttstock?
Fyra i rad ger oss ett ovanligt tydligt svar på om ett beslut var bra. Spelet är löst. En exakt lösare kan tala om huruvida en ställning leder till vinst, oavgjort eller förlust vid perfekt spel, och om ett drag bevarar det utfallet.
Det gjorde att vi kunde ställa en precis fråga om den mindre modellen. I stället för att bedöma om en mening lät övertygande kunde vi granska 17 325 utvärderingsställningar och sedan låta modellerna spela hela partier. Även träningsetiketterna kom från en exakt lösare, byggd på Benjamin Ralls MIT-licensierade connect-four-ai. Modellen lärde sig från dessa etiketter; den upptäckte inte spelet på egen hand.
Om målet bara är en stark motståndare i fyra i rad är lösaren fortfarande ett bra val. Dess WebAssembly-version på 1,26 MB är mindre än till och med vår ternära modellfil. Experimentet handlar om att lära in kompakta beslut, med ett spel där vi kan kontrollera svaren. Andra uppgifter kan erbjuda exempel på bra beslut utan att det finns en exakt lösare att använda när modellen ska köras.
Tre värden, packade på två sätt
En vikt lagrar normalt ett tal med många möjliga värden. Ternära vikter begränsar valet till tre. I varje grupp om 128 vikter omvandlar en gemensam skalfaktor de lagrade värdena −1, 0 och +1 till de värden modellen använder. En skalfaktor på 0,08 ger till exempel −0,08, 0 och +0,08.
Samma idé med tre värden finns i BitNet b1.58.2 Vi testade två sätt att ordna och packa dessa värden; det var ingen jämförelse med BitNets träningsrecept.
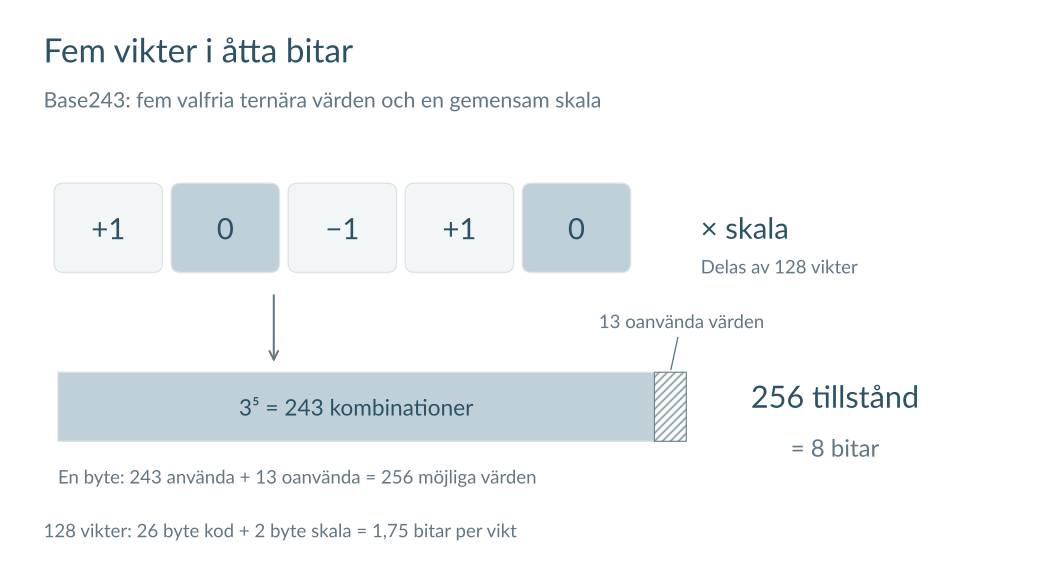
Base243, vårt namn på packningen i bas 3 som används i llama.cpp:s TQ1_0-format, tillåter alla kombinationer av de tre värdena. Fem ternära värden har möjliga kombinationer och ryms därför i en bytes 256 tillstånd. Våra grupper om 128 vikter använder 26 byte för koderna, inklusive utfyllnad, och två byte för en skalfaktor i fp16: 1,75 bitar per ternär vikt, inklusive dess andel av skalfaktorn. De fem värdena använder 243 av en bytes 256 möjliga värden och lämnar 13 oanvända. Det är oanvänd kapacitet i kodningen, inte en hel ledig bit.
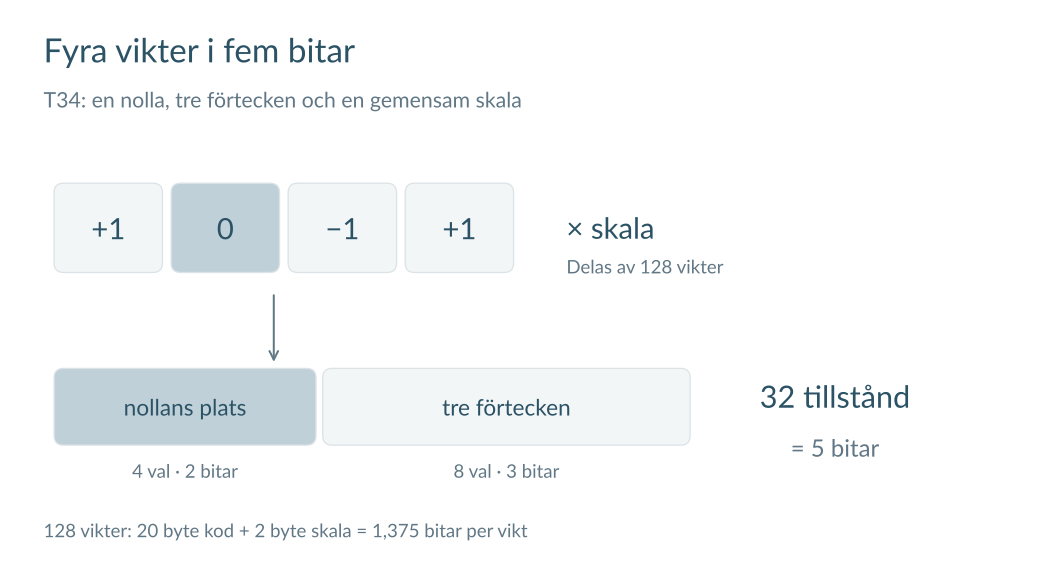
T34, vår förkortning för Sherrys 3:4-format, lägger till en begränsning: i varje grupp om fyra vikter är exakt en noll och de övriga tre antingen −1 eller +1. Nollan kan ligga på fyra platser och förtecknen kan kombineras på åtta sätt. Det ger tillstånd, som ryms i fem bitar. Med den gemensamma skalfaktorn tar en grupp om 128 vikter 22 byte: 1,375 bitar per ternär vikt.3
Ingen av filerna är helt ternär. Byte-embeddingen och poängsättningslagrets matriser är fortfarande int8; positionskodningar, bias och normaliseringsparametrar använder fp16. Även dessa mindre delar tar plats, liksom skalfaktorerna och ONNX-grafen. Siffran 1,59 MB avser hela T34-modellfilen, inte bara dess packade koder.
Låt modellen möta begränsningen medan den lär sig
För båda formaten testade vi tre vägar till en liten fil:
- Konvertera efter träning. Utgå från den färdiga v2-modellen och anpassa vikterna till det ternära formatet, utan ytterligare inlärning.
- Finjustera med ternära vikter. Utgå från v2, men låt modellen anpassa sig medan den använder de begränsade vikterna i sina framåtpass.
- Träna med ternära vikter från början. Utgå från slumpmässiga vikter och använd ursprungliga data och träningsschema, med samma begränsning.
Innan vi körde jämförelsen med sex modeller bestämde vi ett enkelt acceptanstest: en fil under 2 MB, bättre spel än vårt lilla första försök och överensstämmelse mellan den exporterade filen och modellen vi utvärderade. Alla sex klarade det. Men det var en lägstanivå. Den mer intressanta frågan var om vi kunde behålla den starkare v2-modellens spelstyrka.
Träningen kördes med MLX på Apple silicon. Den behöll flyttalsvikter för optimeraren, men ersatte dem med deras kvantiserade värden i varje framåtpass. En straight-through-gradient lät inlärningen uppdatera de underliggande vikterna trots det diskreta avrundningssteget. Den exporterade filen använde sedan samma kvantiseringsregel.4
Finjusteringarna tog 12 000 steg och lärde sig också från v2:s fördelning av poäng för dragen. De ursprungliga körningarna från grunden följde schemat med två etapper, först 6 000 och sedan 12 000 träningssteg, med lösarens etiketter men utan v2 som extra lärare. Det här är nya tränade modeller, inte alternativa förpackningar av oförändrade vikter.
En liten fil räcker inte
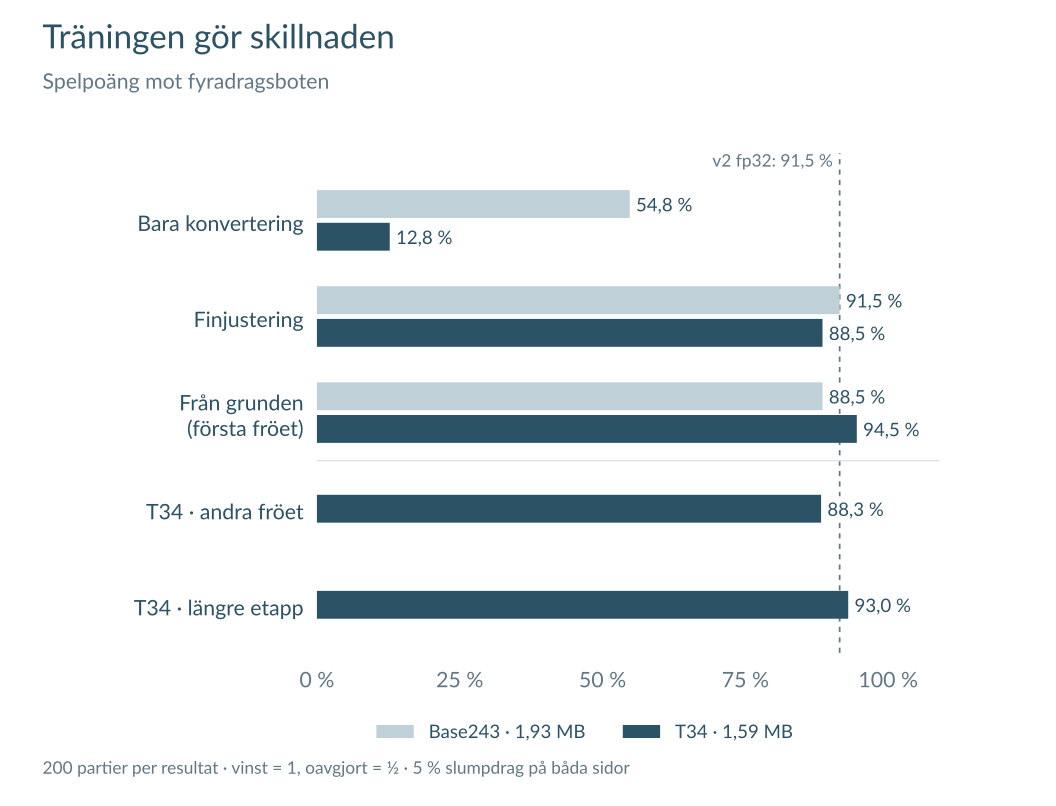
Varje speljämförelse omfattade 200 partier från ett tomt bräde, med växlande färger. På båda sidor valdes ett slumpmässigt drag 5 % av gångerna. En vinst gav en poäng och oavgjort en halv. Procenttalen nedan är andelar av de möjliga poängen, inte nödvändigtvis andelar vunna partier.
| Modell | Fil | bpw | Fyradragsbot | Sexdragsbot |
|---|---|---|---|---|
| v2, ursprunglig fp32 | 29,7 MB | 32,20 | 91,5 % | 89,3 % |
| v2, ursprunglig int8-export | 7,8 MB | 8,47 | 90,5 % | 87,8 % |
| Base243, bara konverterad | 1,93 MB | 2,09 | 54,8 % | 51,3 % |
| T34, bara konverterad | 1,59 MB | 1,73 | 12,8 % | 10,8 % |
| Base243, finjusterad | 1,93 MB | 2,09 | 91,5 % | 88,0 % |
| T34, finjusterad | 1,59 MB | 1,73 | 88,5 % | 89,5 % |
| Base243, tränad från grunden | 1,93 MB | 2,09 | 88,5 % | 87,8 % |
| T34, första träningen från grunden | 1,59 MB | 1,73 | 94,5 % | 87,0 % |
Här betyder bpw effektiva bitar per modellparameter: hela filstorleken i byte × 8 ÷ 7 382 528 parametrar. Det inkluderar skalfaktorer, de icke-ternära delarna och grafens overhead, och är därför högre än siffrorna för packade vikter ovan.
Alla fyra modeller som tränades med ternära vikter nådde de krav på starkt spel som användes för originalmodellen. Ingen av de två enbart konverterade modellerna gjorde det. På utvärderingsställningar bevarade de tränade modellerna spelets exakta utfall i 98,5-98,7 % av dragen, jämfört med 98,7 % för fp32 v2. Enbart konvertering nådde 92,0 % med Base243 och 86,0 % med T34.
Två ytterligare slumpfrön för partierna placerade alla fyra tränade ternära modeller mellan 86 % och 95 % mot fyradragsboten. Det är fler spelkörningar, inte oberoende tränade modeller. Att låta en tränad modell spela igen och att träna en ny modell besvarar olika frågor.
Håller resultatet efter en ny träning?
Vi tränade T34 från grunden igen med samma recept men ett annat slumpfrö. Resultatet på utvärderingsställningar låg nära: 98,4 % drag som bevarade utfallet, mot den första körningens 98,5 %. Poängen mot fyradragsboten blev däremot lägre: 88,3 % i stället för 94,5 %. Det första resultatet var en gynnsam körning, inte en siffra vi bör förvänta oss att varje träning återskapar.
Vi testade också en längre sista träningsetapp, planerad innan den körningen började. Den första etappen var oförändrad, medan den andra fick 24 000 träningssteg i stället för 12 000. Filen var fortfarande 1,59 MB.
| T34-träning | Fyradragsbot | Sexdragsbot | Bevarat utfall |
|---|---|---|---|
| Ursprungligt schema, första fröet | 94,5 % | 87,0 % | 98,5 % |
| Ursprungligt schema, andra fröet | 88,3 % | 89,3 % | 98,4 % |
| Längre sista etapp | 93,0 % | 91,0 % | 98,9 % |
Mer träning förbättrade resultatet på utvärderingsställningar och poängen mot den djupare sökande boten, utan att modellen blev en enda byte större. Den längre tränade modellen fick 92,5-93,5 % mot fyradragsboten över tre slumpfrön för partierna, och 88,5-92,3 % mot sexdragsboten. Det är den här filen som ligger bakom artikelns huvudresultat.5
Det visar fortfarande inte att T34 generellt är en starkare spelare än v2. Mot den perfekta spelaren fick den längre tränade modellen 42,8 %, jämfört med v2:s 47,5 %, under samma spelregler med slumpmässiga drag. De primära poängen mot fyradragsboten har överlappande rapporterade 95-procentiga intervall: 88,6-95,8 % för den längre tränade T34 och 86,8-94,6 % för fp32 v2. Bara det ursprungliga receptet för T34 från grunden har upprepats med ett andra slumpfrö för träningen; det längre schemat och de andra träningsrecepten har en körning vardera.
Partierna i speltestet upprepar sig dessutom. Mot den deterministiska fyradragsboten var bara 95-137 av de 200 partierna unika för de tränade ternära modellerna, trots de slumpmässiga dragen. Poängen beskriver ett snävare urval av partier än de 17 325 utvärderingsställningarna. Intervallen fångar variation inom speltestet, inte osäkerheten från att träna om modellen eller välja en annan motståndare.
Vikterna närmast originalet gav inte de bästa dragen
Resultatet från enbart konvertering lämnade en fråga. Var inlärning nödvändig, eller hade vi bara valt ett dåligt sätt att avbilda originalvikterna på tre värden?
Vi undersökte 60 varianter utan träning och ändrade gruppstorlek, anpassningsregel eller vilka matriser som blev ternära. Den mest lärorika justeringen gällde skalfaktorn, i en uppföljande undersökning efter de första resultaten.
Den ursprungliga anpassningen minimerade kvadratfelet mellan originalvikterna och de ternära vikterna. För T34 satte anpassningen den till beloppet minsta vikten i varje grupp om fyra till noll och bestämde den gemensamma skalfaktorn utifrån de övriga beloppen. Det är ett rimligt svar på ett numeriskt approximationsproblem. Det var ett dåligt svar på hur modellens beslut skulle bevaras.
| Ändring vid konvertering | Fyradragsbot | Bevarat utfall |
|---|---|---|
| T34, minsta kvadratmetoden | 12,8 % | 86,0 % |
| T34, annan skala, samma nollor | 80,5 % | 92,2 % |
| Base243, minsta kvadratmetoden | 54,8 % | 92,0 % |
| Base243, samma skala gånger 1,2 | 80,5 % | 96,5 % |
Den alternativa T34-skalan kom från en Lloyd-Max-regel för normalfördelade värden, baserad på det kvadratiska medelvärdet av vikternas belopp i varje grupp. Den ändrade hur stora de kvarvarande vikterna var, utan att ändra vilka som var noll. Base243-justeringen var ännu enklare: gör samma skalfaktor 20 % större.6
En bättre approximation av originalvikterna var inte nödvändigtvis en bättre approximation av vad modellen gjorde. Lärdomen är att mäta de beslut man bryr sig om, inte bara felet som införs i de lagrade talen.
Attention-matriserna som bildar queries, keys och values var särskilt känsliga för konvertering. Inom budgeten på 2 MB nådde den bästa varianten utan träning 96,5 % drag som bevarade utfallet, mot 98,4-98,9 % för de tränade modellerna. Att behålla alla attention-matriser i int8 tog Base243 till 98,1 % utan träning, men enbart dess tensorer upptog cirka 3,7 MB. Det återställde mycket av spelstyrkan, men gav upp en stor del av storleksminskningen.
Packat på disk, packat på GPU:n
De ternära filerna körs i samma onepass-webgpu-körmiljö som hastighetsexperimentet, med ett litet formattillägg. GPU:n läser de packade vikterna och avkodar dem inne i matrismultiplikationens kernels, i stället för att först expandera varje matris till en fullständig flyttalskopia.
För T34 innebär det att plocka ut ett fembitarstillstånd, hitta nollan, läsa de tre förtecknen och tillämpa gruppens skalfaktor. Beräkningarna använder fortfarande flyttalsaritmetik. En kompakt viktrepresentation innebär inte att webbläsaren har blivit en ternär dator.
Vi kontrollerade de ursprungliga Base243- och T34-exporterna tränade från grunden, och den längre tränade T34, med referensavkodningen i ONNX Runtime. Sedan jämförde vi WebGPU med varje fils egen referens på samtliga 17 325 utvärderingsställningar. Alla tre filer valde samma kolumn som sin egen referens på varje testad ställning. Det kontrollerar att webbläsaren kör modellen vi utvärderade; det betyder inte att modellerna alltid väljer samma drag som v2.7
På en M5 Pro utan annan belastning, med Chrome 154 och Metal, gav jämförelsen av uppvärmda körningar följande:
| Modellfil | Nedladdning | Per drag | GPU-vikter |
|---|---|---|---|
| v2 fp32 | 29,7 MB | 1,3 ms | 29,5 MB |
| v2 int8 | 7,8 MB | 0,9 ms | 7,7 MB |
| T34, första träningen från grunden | 1,59 MB | 1,1 ms | 1,96 MB |
| Base243, tränad från grunden | 1,93 MB | 1,3 ms | 2,30 MB |
Varje rad är medianen av tre körningars medianer, med 500 tidtagna ställningar efter 20 uppvärmningar per körning. Det är uppvärmda beslut, inte tid för sidladdning eller första draget. Minneskolumnen räknar viktbuffertar, inte allt minne i webbläsaren eller på GPU:n.8
T34-filen som tidtogs kom från den ursprungliga träningen. Den längre tränade filen använder samma format, matrisformer och kernels, men tabellen är ingen ny tidsmätning av den filen.
Vinsten här är storleken, inte hastigheten. T34 är ungefär en femtedel så stor som int8-filen, men något långsammare i denna körmiljö. Dess modell på 1,59 MB åtföljs av ungefär 37 KB körmiljökod och ett formattillägg på 6,5 KB, före nätverkskomprimering och sidans separata resurser. Den mindre filen förblir liten under körning, medan den extra avkodningen fortfarande kostar.
T34:s kernel har ännu inte optimerats för formatet. Vi behöll körmiljön och kernelstrukturen och ändrade hur vikterna läses. Varje avkodat värde multipliceras med gruppens skalfaktor före en vanlig multiplikation och addition i flyttal. Med 64 ställningar per anrop tog T34 0,38 ms per ställning mot fp32:s 0,32 ms, cirka 18 % längre i samma tidstest. Det är siffror för genomströmning vid batchning, inte dragtiderna i tabellen ovan.
Det finns konkreta optimeringar att prova: tillämpa den gemensamma skalfaktorn en gång per grupp, eller återanvänd varje avkodad vikt för fler ställningar. En heltalsbaserad beräkningsväg, likt dem som undersökts för BitNet-inferens, är en annan möjlighet, men den skulle också kvantisera aktiveringarna och behöva nya kontroller av noggrannheten.9 Mätningarna beskriver vår nuvarande implementation, inte någon inneboende hastighetsgräns för ternära vikter.
Vad ryms i en mindre motståndare?
Vi började med en praktisk fråga: kunde webbläsaren ladda ned betydligt mindre utan att en kapabel motståndare blev en lätt match?
För den här arkitekturen med 7,4 miljoner parametrar, dessa träningsdata och det här spelet var svaret ja. Den längre tränade T34-modellen på 1,59 MB behöll en liknande spelstyrka som vår tidigare modell och bevarade spelets utfall på 98,9 % av utvärderingsställningarna. Genvägen att konvertera färdiga vikter förlorade betydligt mer. En justerad skalfaktor återställde en del av förlusten; träning med begränsningen på plats återställde mer.
Det antyder en användbar arbetsordning för en annan liten beslutsmodell: välj en representation som går att leverera, låt modellen möta den under inlärningen och kontrollera den exporterade filen på beslut som spelar roll. Upprepa träningen också: skillnaden mellan våra två första T34-körningar påminde om att en bra checkpoint och ett reproducerbart recept är olika saker. Ett välbekant numeriskt felmått ger bara en del av svaret.
Experimentet omfattar en modellstorlek och en uppgift, med webbläsarmätningar på Apple silicon i Chrome. Om en annan uppgift eller en större modell anpassar sig lika lätt är en fråga för ett eget experiment. Lösaren för fyra i rad gjorde det här ovanligt lätt att bedöma.
En liten nedladdning kan vara ett designmål från första träningssteget. Små ternära modeller skulle kunna ge användbara beslut i fler spel, appar och webbläsarverktyg, utan att varje val behöver skickas till en modell i molnet. Fyra i rad är en början. Nästa intressanta fråga är vilka fler förmågor vi kan få plats med.
Prova de ternära modellerna i din webbläsare och se hur mycket motstånd som ryms i en modell på 1,6 MB, och hur snabbt inferensen körs lokalt. Kan du slå den?
Fotnoter
-
Jämförelsen med sex modeller, filstorlekar och spelresultat finns i sammanställningen, med acceptanskraven fastställda före den första körningen och råa mätdata tillgängliga för granskning. Det ursprungliga v2-receptet och dess utvärdering finns i one-pass-specialists; int8-exporten och fp32-modellen har separata jämförelserader här. ↩
-
Ma med flera, The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits, 2024, beskriver BitNet b1.58:s ternära vikter. Vi har inte gjort en matchad kvalitetsjämförelse med dess träningsrecept. ↩
-
Huang med flera, Sherry: Hardware-Efficient 1.25-Bit Ternary Quantization via Fine-grained Sparsification, 2026, beskriver 3:4-formatet vi kallar T34. Packning av fem ternära värden per byte i bas 3 implementerades av compilade i llama.cpp PR #8151 för BitNet b1.58- och TriLM-modeller 2024. Vår codec-implementation finns tillsammans med testerna. Vår gruppstorlek och hantering av skalfaktorer anges ovan; att använda dessa packningsformat innebär inte att använda artiklarnas fullständiga träningsmetoder. ↩
-
Träningen använder MLX. För de bakomliggande teknikerna, se Bengio, Léonard och Courville, Estimating or Propagating Gradients Through Stochastic Neurons for Conditional Computation, 2013, om straight-through-estimering, och Hinton, Vinyals och Dean, Distilling the Knowledge in a Neural Network, 2015, om att lära från en lärares utdata. Se vår MLX-träningskod och skripten för det andra slumpfröet och den längre etappen. ↩
-
De råa utvärderingsresultaten omfattar det andra slumpfröet för träningen och den längre sista etappen. Procenttal avrundas direkt från råa spelpoäng: 0,8825 blir 88,3 %, 0,8925 blir 89,3 %, 0,9225 blir 92,3 % och 0,4275 blir 42,8 %. Den längre tränade exporten innehåller 1 593 727 byte; dess SHA-256 i verifieringsprotokollet matchar T34-filen på Hugging Face. ↩
-
Metoden för skalanpassning bygger på Lloyd, Least squares quantization in PCM, 1982, och Max, Quantizing for minimum distortion, 1960. Vår undersökning av skalfaktorer var en uppföljning till den första genomgången av varianter, inte en del av den ursprungliga jämförelsen med sex modeller. Se undersökningsplanen med daterat tillägg och resultaten. ↩
-
Referensavkodningen lagras som en lokal funktion i ONNX-modellen, som ONNX Runtime kan köra utan tillägg. WebGPU-överensstämmelsen på samtliga ställningar mättes på en M1 Max, separat från tidstestet på M5 Pro. De ursprungliga Base243- och T34-exporterna och den längre tränade T34 matchade var och en sin egen avkodade referens i 17 325 av 17 325 val. Se protokollet för WebGPU-överensstämmelse och koden för exportverifiering. ↩
-
Se det offentliga hastighetsprotokollet och vår föregående artikel om hastighet. Det frysta tidsprotokollet från 28 september använder körmiljöversion
517cb46, Chrome 154 i headless-läge med en Metal-adapter, en Apple M5 Pro utan annan belastning och tre körningar. Int8-resultatet här är 0,9 ms; den tidigare artikelns separata körning avrundades till 1,0 ms. ↩ -
Jämförelsen med batchstorlek 64 kommer från samma tidsprotokoll som tabellen per drag. Se kernelkoden för ternära vikter och optimeringsanteckningarna. För närliggande arbete med heltalskernels, se Wang med flera, 1-bit AI Infra: Part 1.1, Fast and Lossless BitNet b1.58 Inference on CPUs, 2024. Det arbetet gäller CPU:er och mäter inte de föreslagna ändringarna av vår WebGPU-implementation. ↩