Möt din AI-motståndare: ett enda framåtpass
Spela fyra i rad mot en lokal AI på 7,8 MB i webbläsaren. En bättre lärare gjorde vår lättslagna modell till en betydligt tuffare motståndare.

Kapitel
Släpp en bricka i en kolumn och se AI:n göra sitt drag. Din motståndare är en modell på 7,8 MB som körs lokalt i din webbläsare. Den läser brädet, ger varje tillåten kolumn en poäng och väljer sin favorit. Ett framåtpass per drag, utan att söka igenom framtida ställningar. I vårt Chromium-test på en M1 Max valde den ett drag på ungefär 20 millisekunder.1
Spela fyra i rad mot den. Du kan börja eller låta modellen öppna. Den visar också vilka kolumner den föredrar, så det finns något att granska medan du planerar din revansch.
Spel har blivit ett lockande sätt att utforska den här sortens AI. När TypeSafe
lanserade Jev i september visade de bland annat ett Doom-demo byggt kring
snabba, strukturerade beslut. Fristående projekt som jevlike och open-jev
utforskar besläktade idéer i Doom och schack.2
Convai Innovations Laya erbjuder öppen källkod och modellvikter för typade beslut utan att generera text. Andra utvecklare har låtit den styra fallande block i Tetris och nästa sväng i Snake. Välbekanta spel gör ett abstrakt gränssnitt ganska roligt att titta på.3
Det tilltalande med sådana beslutsmodeller blir tydligt i ett spel. Programmet känner till det aktuella läget och de möjliga handlingarna. Modellens uppgift är att bedöma vilken handling som är bäst. Det är en liten, användbar uppgift där maskininlärning kan få plats i vanlig programvara.
Vår förra OnePass-artikel utforskade idén med en svensk formulärspecialist. Vi ville prova den i ett sammanhang där följderna syns tydligare och där läsaren kan vara med. Det här är en ny modell tränad för fyra i rad med öppen kod. Den använder varken TypeSafes Jev-modell eller API, eller Layas vikter.
Vårt första försök var en lätt motståndare. Två dagar senare vann en reviderad version ungefär nio av tio partier mot en sökbot som såg fyra drag framåt, enligt våra testregler. Vägen dit lärde oss mer om vad modellen behöver lära sig än den lilla nedladdningen kanske antyder.
För en produkt med fyra i rad vore en sökbaserad motståndare ett rimligt val. Fyradragsboten är vår enkla jämförelse. Den exakta spellösare vi använder som lärare kan spela perfekt och finns redan i en webbläsarversion. Dess WebAssembly-modul och JavaScript är tillsammans ungefär 1,29 MB, inklusive öppningsboken, jämfört med 7,82 MB för enbart vår modell, innan dess körmiljö lagts till.4
Det finns också en skillnad i när arbetet görs. Lösaren söker under spelets gång, och mängden sökning beror på ställningen. Vår modell kör samma fasta nätverksberäkning för varje drag. Det gör beräkningsarbetet mer förutsägbart.5
För att göra variationen konkret mätte vi en nativ version på en M5 Pro. I 200 ställningar, åtta drag in i partiet, tog det i median 0,84 sekunder att poängsätta alla tillåtna kolumner. Den långsammaste tog 16,6 sekunder. Öppningsboken kan göra de allra första dragen mycket billigare. Mätningarna visar hur sökarbetet varierar; de är inte ett jämförande hastighetstest med samma förutsättningar som för webbläsarmodellen.6
För spelaren är modellens fördel en kort, förutsägbar betänketid genom hela partiet. Den kör samma fasta beräkning i öppningen, mittspelet och slutspelet. I vårt webbläsartest på en M1 Max mätte vi ungefär 20 millisekunder per drag.1
Vi valde fyra i rad för att utforska hur en modell lär sig fatta beslut. Ett löst spel låter oss kontrollera dess val mot exakta svar. I andra spel eller tillämpningar kanske det inte finns någon praktiskt användbar exakt lösare. Träningsexempel skulle i stället kunna komma från skickliga spelare, ett långsammare planeringssystem eller observerade utfall. Det här brädet ger oss en tydlig plats att börja på.
Ett bräde, sju alternativ, ett beslut
Fyra i rad har ett litet ordförråd: sju kolumner, sex rader och fyra brickor i rad för att vinna. Nästa drag är ett val bland de kolumner som inte är fulla. Det passar OnePass-gränssnittet väl.
Modellen får en beskrivning på 44 byte: om den är spelare ett eller två,
följt av 42 rutor ur dess eget perspektiv. En ruta är tom, min eller
motståndarens. De möjliga handlingarna är korta strängar som column 3 och
column 7. En beräkning genom nätverket ger en poäng för varje tillåten
handling.7
Programmet kontrollerar fortfarande att drag är tillåtna, släpper brickan och upptäcker en vinst. Modellen står för spelstrategin. Den bygger inte ett träd av framtida drag, anropar inte någon lösare och skriver inget textsvar innan den väljer.
Det är en liten transformer från samma arkitekturfamilj som vår formulärspecialist, uppskalad till 7,4 miljoner parametrar, med nya vikter tränade för spelet. Den bygger på den öppna Cua-S1-modellen, vars attention-huvud för alternativ kommer från jevlike-projektet.8
Staplarna i demot gör det avgränsade gränssnittet synligt. De visar relativa preferenser utifrån modellens poäng, inte uppmätta vinstchanser. De kan inte berätta varför modellen gillar ett drag, men de låter oss se vad den valde framför alternativen.
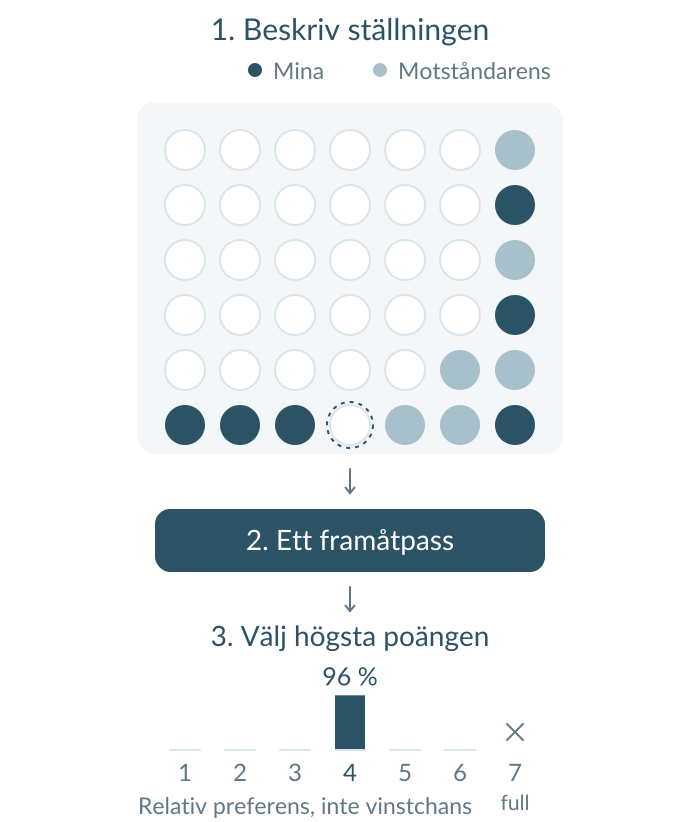
Bilden ovan visar en enkel ställning som gör gränssnittet konkret. Kolumn 7 är redan full och är därför inget alternativ. Den markerade rutan i kolumn 4 fullbordar raden. Preferenserna kommer från den publicerade int8-modellens beräkning av det här brädet i nativ ONNX Runtime. Du kan granska ställningen och modellens poäng.
Vår första AI-spelare var en lätt motståndare
Det första försöket, som avslutades den 24 september, hade ungefär 0,7 miljoner parametrar. Det slog nästan aldrig en enkel bot som sökte fyra drag framåt. Med det senare testprotokollet vann det bara sex av 200 partier mot boten.
Det fanns en stor lucka i undervisningen. Den exakta lösare vi först använde var praktiskt användbar bara nära slutet av ett parti, med högst 16 tomma rutor. De flesta träningsställningarna var slumpmässiga fyllningar av sådana sena bräden. Modellen fick se hur ett bra slut såg ut, men saknade exakta besked om stora delar av öppningen och mittspelet.9
En liten uppsättning öppningspartier, uppmärkta av fyradragsboten, gav ingen tydlig förbättring. Vi hade breddat lektionen, men läraren såg fortfarande bara en begränsad del av spelet. Ett rimligt nästa drag från en grund sökning är inte samma sak som att veta vilka drag som bevarar en vinst.
Det fanns en annan varningssignal: ett respektabelt resultat på enskilda ställningar blev inte bra partier. En spelare måste behålla sitt övertag från ett beslut till nästa. Vi behövde förbättra träningen och fortsätta spela hela partier för att se om det hjälpte.
Att lära v2 hela spelet
Fyra i rad ger oss en ovanligt hjälpsam lärare: spelet är löst. En exakt lösare kan avgöra om ett drag bevarar en framtvingad vinst, ett oavgjort resultat eller en förlust, om båda spelar perfekt därefter. Vi behöver inte gissa om en träningsetikett är bra.
I det andra försöket använde vi Benjamin Ralls MIT-licensierade connect-four-ai för att märka upp ställningar genom hela spelet. Vi använde också den MIT-licensierade datamängden TonyCWang/ConnectFour, som redan innehåller exakta etiketter från Pascal Pons lösare.
Underlaget växte till ungefär 42 miljoner ställningar: 41,6 miljoner från datamängden och ytterligare 513 tusen genererade från partier mellan spelare av olika styrka. De svagare spelarna spelar roll. En mänsklig motståndare följer inte alltid lärarens favoritlinje, och modellen behöver också exempel på vad som händer efter ett misstag.
Vi gjorde även brädet lättare att läsa. I stället för ett längre textrutnät och en draghistorik fick varje ruta en fast plats i en kompakt beskrivning, alltid ur nästa spelares perspektiv. I en tidig diagnostisk körning blev även en modell i den gamla storleken mycket känsligare för vem som ägde varje bricka. Det gav oss skäl att fortsätta arbeta med träningsupplägget innan vi skyllde på grundarkitekturen.
Lär ut hur dragen förhåller sig till varandra
Vi ändrade också träningsmålet. I stället för att lära ut en enda rätt kolumn tränade vi modellen att rangordna alla tillåtna drag: bevara en vinst framför att nöja sig med oavgjort, föredra en snabbare vinst och skjuta upp en oundviklig förlust.
Flera kolumner kan vara bra. Att behandla en som rätt och de andra som fel kastar bort information som lösaren redan har. Det nya målet lär ut relationerna mellan de tillåtna alternativen. I träningsjämförelserna fungerade detta rangordningsmål också bättre än ett mål som behandlade alla drag som bevarar ställningens värde lika.10
Sedan ökade vi kapaciteten. En mellanstor modell och den större versionen hade mycket likartad träffsäkerhet på enskilda ställningar, men deras spelresultat skilde sig kraftigt. Det större nätverket var värt att behålla för att det spelade bättre, inte för att valideringssiffran såg dramatiskt annorlunda ut.10 Ytterligare träning höjde också modellens resultat med full precision mot en sökbot som såg två drag framåt, från 64,3 % till 90,5 %.11
Förbättringen kom från ett omarbetat träningsupplägg, inte bara en större modell. Etiketter, exempel, indataformat, mål och kapacitet ändrades. Det publicerade receptet innehåller jämförelserna längs vägen.9
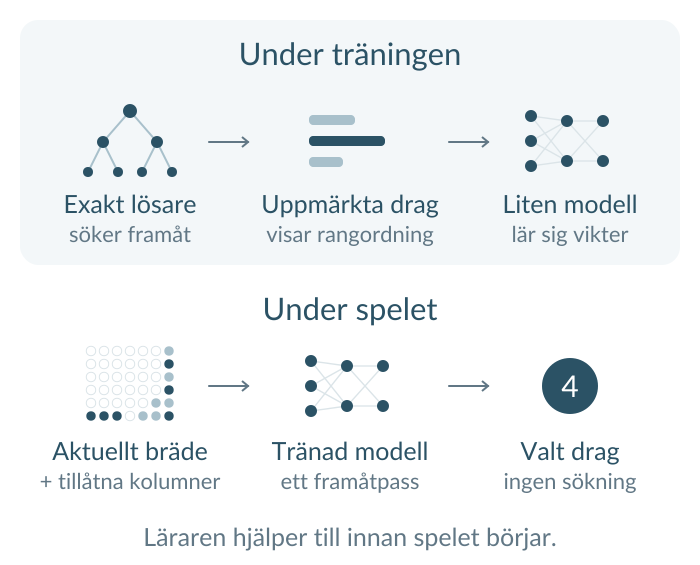
Lösaren utforskar vad som kan hända härnäst för att skapa undervisningssignalen. Eleven lär sig av svaren och kan senare välja ett drag utan att göra om sökningen. Lärarens säkerhet följer inte med fullt ut: eleven är en approximation, och vi måste fortfarande ta reda på hur bra den spelar.
Vad förändrades på brädet?
Vi låste reglerna för speltesterna innan vi tränade den andra versionen. Varje matchserie innehåller 200 partier från ett tomt bräde, med spelarna växelvis först. Vid varje tur har båda spelarna 5 % chans att göra ett slumpmässigt valt tillåtet drag, med lika sannolikhet för alla alternativ. Det ger variation i stället för att samma deterministiska parti spelas om, även om vissa partier fortfarande upprepas. En vinst ger en poäng, oavgjort en halv.12
Här är huvudresultaten. De två sökbotarna ser fyra respektive sex drag framåt, där en spelares tur räknas som ett drag. De tränade spelarna söker inte. Webbläsarversionen använder int8-kvantisering: de flesta vikter lagras som åttabitars heltal i stället för 32-bitars flyttal, vilket gör filen mindre.
| Motståndare | Första versionen | v2, full precision | v2, int8 för webbläsaren |
|---|---|---|---|
| Sökbot, fyra drag | 3,0 % | 91,5 % | 90,5 % |
| Sökbot, sex drag | 2,0 % | 89,25 % | 87,75 % |
Procentsatserna anger andelen möjliga poäng enligt reglerna ovan. Int8-resultaten gäller samma komprimerade fil som skickas till webbläsarna, men dessa partier kördes med nativ ONNX Runtime.13
Den nedladdningsbara modellen slog fyradragsboten i 181 av 200 partier. Modellen med full precision vann 183. Det spelar roll att hålla resultaten isär: att krympa en modell för leverans är ytterligare en förändring att utvärdera, inte bara en mindre nedladdning.
Som referens fick den exakta lösaren 89 % mot fyradragsboten med samma regler. Det är lägre än båda v2-resultaten, men gör inte vår modell bättre än lösaren. Även lösaren drabbas av de påtvingade slumpdragen, och antalet partier är begränsat. I en direkt matchserie mot lösaren fick modellen med full precision 47,5 %, alltså ungefär jämnt under dessa regler med slumpinslag. Det är inget påstående om perfekt spel.13
Separata tester i webbläsararenan gav glädjande 200-0 mot v1. Arenan använder slumpmässiga öppningsdrag i stället för 5 % slumpdrag genom hela partiet, så det är ett annat test. Det innehöll 83 olika partier, inte 200 unika. Det visar framsteget på ett konkret sätt, men är inget mått på styrkan mot mänskliga spelare.1
En kontroll ställning för ställning ger en annan bild. På 17 325 testställningar valde filerna med full precision respektive int8 samma kolumn 98,2 % av gångerna. Båda bevarade ställningens värde (vinst, oavgjort eller förlust) i ungefär 98,7 % av ställningarna.14 Testställningar med minst 12 brickor hölls utanför träningen; tidigare ställningar kunde överlappa. De återstående misstagen spelar fortfarande roll: under ett parti får en spelare flera tillfällen att tappa ett bra läge.15
Webbläsarversionen körs med WebAssembly, som låter en webbsida köra kompilerad kod lokalt i webbläsaren. När modellen och körmiljön väl har laddats ner behövs ingen server för att poängsätta ett drag. Siffran 7,8 MB gäller modellfilen som laddas ner från Hugging Face (exklusive körmiljön i webbläsaren).
Se koden: träning på Apple Silicon
Vi gjorde träningen på Apple Silicon. Den publicerade modellen tränades med MLX på en Apple M5 Pro, med de uppmärkta brädena och dragrangordningarna ovan. Träningen hade två steg, med lägre inlärningstakt i det andra.
| Träningskörning | Värde |
|---|---|
| Modellstorlek | 7,4 miljoner parametrar |
| Träningssteg | 6 000 + 12 000 |
| Batchstorlek | 1 024 ställningar |
| Samplade exempel | 18,4 miljoner |
| Indatatoken | 812 miljoner bytetoken |
| Träningstid | Ungefär två timmar |
Varje brädbeskrivning använder 44 bytetoken. Tokentotalen innehåller också kolumnetiketterna, som MLX-träningen kodar en gång per batch och delar mellan dess bräden.16 Samma ställning kan samplas igen, så antalet exempel är inte antalet unika bräden.9
Vårt AI-recept för fyra i rad följer hela processen: förbered uppmärkta data, uteslut testställningar, träna, spela utvärderingspartierna och exportera modellen. Där finns protokollet och resultatfilerna bakom artikelns siffror.
MLX-träningskoden kör samma modell och träningsupplägg som verktygspaketets PyTorch-implementation. Den sparar portabla vikter och kontrollerar den sparade modellen mot PyTorch-versionen. Exportskriptet använder sedan den versionen för att skapa en ONNX-fil. Vi använder ONNX Runtimes dynamiska int8-kvantisering, som krymper modellfilen från 29,7 MB till 7,8 MB, och utvärderar den kvantiserade filen igen innan vi lägger den i webbläsaren. Det kräver varken omträning eller kalibreringsdata: viktmatriserna och embedding-tabellen lagras med åtta bitar, medan delar som lagernormalisering och bias ligger kvar i float32.17
I onepass-web-repot finns den andra halvan: spelet, brädkodningen och körmiljön för webbläsaren. Träningen använder MLX; webbläsaren använder ONNX Runtime Web med WebAssembly. Spelaren behöver varken MLX eller en Apple-dator för att prova resultatet.
Slutsats: ditt drag
Det viktiga steget från v1 till v2 var en undervisning som täckte hela spelet och alla tillåtna val. Det innebar exempel från hela spelet, även misstag, och ett mål som visade hur de tillåtna dragen förhöll sig till varandra. En större modell hjälpte, men hela partier fick avgöra om förändringarna hade gjort den till en bättre motståndare.
Det är den delen vi hoppas att andra vill ta vidare. En ledtråd i ett pusselspel, en turbaserad motståndare eller en figur som väljer sin nästa handling kan vara intressanta uppgifter för en liten beslutsmodell. Samma gränssnitt kan användas i ett webbläsarspel eller en app: spelkoden ger tillståndet och de tillåtna handlingarna, modellen poängsätter dem och spelet utför valet.
Våra vikter för fyra i rad är en specialist för just det här brädet. Ett annat spel skulle behöva egna exempel och egen utvärdering, kanske med en lösare, en befintlig spelbot eller inspelade drag från skickliga spelare som lärare. De öppna verktygen finns där för nästa experiment.
För oss är det här också en början. Det finns många fler beslut att lära ut och många roliga spel att prova. Ett spel är ett fint sätt att uppleva AI, upptäcka vad en modell har lärt sig och ge en mänsklig spelare en rolig utmaning.
För stunden finns en ledig plats på andra sidan brädet. Kan du slå vår modell?
Fotnoter
-
Den offentliga dokumentationen för demot, implementationen och modellkortet beskriver demot, tillgängliga modeller och arenareglerna. Standardversionen använder WebAssembly. ↩ ↩2 ↩3
-
TypeSafe presenterade Jev den 15 september 2026, med Doom bland sina lanseringsdemonstrationer. Det fristående jevlike-projektet innehåller experiment med Doom och schack; daseinlabs/open-jev visar lokal poängsättning av alternativ med Gemma och en handlingsmeny för Doom. Det är exempel på besläktade gränssnitt, inte belägg för att modellerna delar TypeSafes arkitektur, träningsmetod eller spelstyrka. ↩
-
Layas modellkort beskriver dess kodare från ModernBERT-familjen och beslutshuvud; kod och vikter har Apache-2.0-licens. Den delar mönstret med strukturerade beslut med vår specialist, men har en annan arkitektur och träning. Tetris-implementationen ger Laya ett begränsat urval av placeringar rangordnade av en heuristik. Snake-demot tillför information från en planerare och har som standard ett synligt säkerhetslager som kan ersätta ett föreslaget drag. Det är exempel på hur modellbeslut kan integreras i spel, inte en jämförelse av spelstyrka utan stöd från annan logik. ↩
-
Den exakta connect-four-ai-lösaren är en annan spelare än vår bot med begränsat sökdjup och har ett eget spelbart webbläsardemo. I det publicerade paketet
connect-four-ai-wasm1.0.0 är.wasm-filen 1 260 614 byte och dess JavaScript-kod 26 817 byte, totalt 1 287 431 byte. Modulen innehåller den förvalda öppningsboken med djup åtta. Vår int8-modellfil är 7 816 833 byte, ungefär 6,1 gånger den summan. Det är okomprimerade filstorlekar, utan gränssnitten och modellens ONNX Runtime, inte överföringsstorlekar, minnesåtgång eller en hastighetsjämförelse. Storleksunderlaget anger versionsbundna nedladdningar, byteantal och hashvärden. ↩ -
Lösarens implementation kontrollerar öppningsboken och söker annars i spelträdet. Modellexporten använder fasta indata: 44 byte för brädet och sju alternativplatser på åtta byte vardera, med otillåtna kolumner maskerade. Beräkningen växer inte med djupet på ställningens möjliga fortsättningar. Fast beräkningsarbete garanterar inte identisk uppmätt tid; detta är ingen tidmätt direktjämförelse mellan lösare och modell. ↩
-
Det publicerade tidsunderlaget och mätskriptet använder en nativ Rust-version av
connect-four-aivid28a112apå en Apple M5 Pro med 18 kärnor. Varje ställning löses på en tråd, med åtta oberoende ställningar parallellt. Sökcachen töms före varje ställning, utanför den tidmätta delen; även uppstart och nedladdningar ligger utanför. Ett urval med fast slumpfrö av 200 UCI-ställningar efter åtta drag tog i median 839,33 ms, vid 95:e percentilen 4 854,392 ms och som mest 16 572,782 ms för att poängsätta alla tillåtna kolumner. Öppningsboken med djup åtta är aktiverad, men varje möjligt drag från dessa ställningar når det nionde draget, utanför boken. Detta mäter varken första draget från ett tomt bräde eller lösarens tid i en webbläsare. Underlaget innehåller även sex referensmängder från Pascal Pons, som visar stor variation mellan ställningar. Modellens ungefär 20 ms kommer från ett separat Chromium/WebAssembly-test på en M1 Max; inget hastighetsförhållande mellan körmiljöerna härleds. ↩ -
Det publicerade indatakontraktet beskriver brädet på 44 byte ur spelarens perspektiv, tillåtna kolumner och bytekodningen. ↩
-
Verktygspaketets information om tredjepartskod anger Cua-S1 och jevlike som källor. Spelmodellen använder samma poängsättningsarkitektur med åtta lager, bredd 256 och 7,38 miljoner parametrar. ↩
-
Det publicerade receptet beskriver data, mål, modellstorlekar och träningsschema. Läraren verifierades också med Pascal Pons offentliga testställningar och UCI:s Connect-4-databas, bidragen av John Tromp med CC BY 4.0-licens. Etiketter från den externa datamängden stickprovskontrollerades genom att lösas på nytt och jämföras med lärarens svar. ↩ ↩2 ↩3
-
Det publicerade receptet beskriver jämförelserna av mål och kapacitet. Efter 6 000 steg fick modellerna med 3,28 respektive 7,38 miljoner parametrar 63 % och 89,5 % mot fyradragsboten enligt det fasta protokollet. Deras andel värdebevarande drag på den fasta ställningsmängden var 97,48 % och 97,77 %. Detta var mellanliggande modeller, inte slutversionen: spelresultat och ställningsresultat. Den diagnostiska körningen i ursprungsstorleken var utforskande och gjordes innan de slutliga uteslutningarna mellan träning och utvärdering infördes. ↩ ↩2
-
Mot tvådragsboten steg resultatet för modellen med full precision från 64,25 % vid mellankontrollen till 90,5 % för den slutliga modellen. Båda matchserierna använder 200 partier, slumpfrö 2026 och regeln med 5 % slumpdrag. En vinst räknas som en poäng och oavgjort som en halv. Slutresultatet råkar vara lika med int8-modellens 90,5 % mot fyradragsboten i den senare tabellen; det är separata matcher med olika motståndare och modellfiler. ↩
-
Det låsta testprotokollet definierar motståndarna och regeln för slumpdrag. Huvudmatcherna använder slumpfrö 2026. Två ytterligare slumpfrön ger resultat på 89,25 % och 90,75 % för modellen med full precision mot fyradragsboten. Det gäller denna motståndare och detta protokoll, inte en allmän styrkerating. ↩
-
Råresultat: v1, v2 med full precision, int8-v2 och lösarreferensen. De rapporterade 95-procentiga Wilson-intervallen mot fyradragsboten är 85,6-93,8 % för int8-v2, 86,8-94,6 % för full precision och 83,9-92,6 % för lösaren. Den direkta matchserien mot lösaren kördes inte för int8-filen. ↩ ↩2
-
Det parade jämförelseunderlaget för full precision och int8 och jämförelseskriptet utvärderar båda ONNX-filerna på samma 17 325 ställningar med CPU-körning i ONNX Runtime 1.30.0 på en M1 Max. De valde olika kolumner i 321 ställningar och var överens i 98,15 % med underlagets avrundning. Båda andelarna värdebevarande drag avrundas till 98,72 %; det är överensstämmelse i totalsiffrorna, inte identiska val eller bevis på lika spelstyrka. Tretton ändrade val påverkade också om ställningens värde som vinst, oavgjort eller förlust bevarades. Medianavståndet mellan de två högsta poängen från modellen med full precision på ställningar med olika val var 0,0044. Antalen kan skilja sig något med heltalskärnor på andra processorer. Underlaget anger hashvärden för båda modellfilerna, inklusive den publicerade int8-fil som används här. ↩
-
Första raden i resultaten med full precision anger måtten för enskilda ställningar. Protokollet utesluter testställningar och deras spegelbilder från träningen när det finns minst 12 brickor på brädet. Värdebevarande frågar om en vinnande ställning förblir vinnande, eller om en ställning som kan sluta oavgjort fortfarande kan göra det, med perfekt spel därefter. Det är inte modellens sannolikhet att vinna ett parti. ↩
-
Beräknat från schemat med 18 000 steg, batchstorlek 1 024 och MLX-framåtpasset: 18 432 000 bräden × 44 kontexttoken = 811 008 000 indatatoken för brädena. Varje steg kodar också sju gemensamma kolumnetiketter på åtta byte, vilket lägger till 18 000 × 7 × 8 = 1 008 000 alternativtoken. Totalt: 812 016 000 bytetoken genom träningens indatakodare, avrundat till 812 miljoner. Utvärdering ingår inte, och bakåtpass eller upprepad bearbetning genom transformerlagren räknas inte som fler token. Dessa fasta byteindata är inte direkt jämförbara med delordstoken vid träning av språkmodeller. ↩
-
Receptet anropar
quantize_dynamicmedweight_type=QuantType.QInt8. Det är kvantisering efter träning: vikterna konverteras efteråt och ONNX Runtime beräknar skalor för aktiveringarna under körning. Inspektion av den versionsbundna int8-filen visar 39 viktmatriser med signerad int8 och en embedding-tabell med uint8, ungefär 99,4 % av de lagrade parametervärdena. Lagernormalisering, bias och positionsvärden ligger kvar i float32, liksom attention-beräkningarnas matrismultiplikationer mellan aktiveringar. Dessa återstående värden, skalor och grafdata bidrar till att filen krymper ungefär 3,8 gånger i stället för exakt fyra. Filstorlekarna finns i det versionsbundna modellkortet; spelresultaten för den kvantiserade filen visas separat i tabellen ovan. ↩