Text som bilder: vad en sida kostar
Apples LensVLM läser dokument som komprimerade sidbilder och hämtar texten bara där den behövs. Vi körde modellen på en Mac och mätte hur mycket kontext en sida tar.

Kapitel
När en rapport är för lång för en modells kontextfönster är en vanlig lösning att dela upp texten och hämta de avsnitt som verkar relevanta. Det sparar plats, men modellen kan bara arbeta med de avsnitt den får. En detalj som hamnar utanför urvalet kan den inte använda.
Apples LensVLM prövar ett annat sätt. Den överblickar hela dokumentet som små sidbilder, väljer vilka sidor som är värda att läsa och ber om deras fullständiga text.1 Tänk dig att sprida ut sidor på ett skrivbord innan du plockar upp en för att läsa. Överblicken finns kvar, och de ursprungliga orden ligger inom räckhåll.
Vi ville se vad det ger på en Mac: hur mycket kontext bilderna sparar, vad som händer när en sida kommer tillbaka som text och om modellen hittar underlaget den behöver. Vi följde ett dokument genom hela förloppet.
Vad modellen gör
LensVLM är en bild- och språkmodell med nio miljarder parametrar som Apple
publicerade den 21 september 2026. Språkdelen är Qwen3.5-9B och bildkodaren
kommer från Qwen3-VL-familjen. Dokumentet renderas till sidbilder, och modellen
får en bild per sida. Den granskar dem, resonerar om vad den ser och anropar
verktyget read_page för att få texten på en sida den vill läsa närmare.2
Apple tillhandahåller tre komprimeringslägen: 5x, 10x och 15x. Varje läge bestämmer sidbredd och teckenstorlek, med en angiven textkapacitet per sida. Renderaren, systemprompten och loopen för verktygsanrop finns i samma publika kodrepo som modellen.3
Modellvikternas licens tillåter bara forskning. Apple Machine Learning Research Model License utesluter kommersiellt utnyttjande, produktutveckling och användning i kommersiella produkter eller tjänster. Koden har en separat Apple Sample Code License. Här undersöker vi hur metoden fungerar; att använda modellen i en produkt skulle kräva ett annat tillstånd.4
Att köra den på en Mac
Apples referensexempel använder vLLM. Vi anpassade dess loop till mlx-vlm på en Apple M4 med 24 GB enhetligt minne och behöll Apples renderare, systemprompt och funktioner för att tolka verktygsanrop och plocka ut svar.5 Fyrabitarskonverteringen av vikterna tar ungefär 8 GB på disk och lästes in på cirka tre sekunder i våra körningar.6
Vi använde exemplet som följer med Apples kodrepo: 32 033 tecken, eller 5 136 ord, sammanställda för en fråga om skådespelerskan som spelade Corliss Archer i Kiss and Tell och den statliga befattning hon senare hade. Referenssvaret, ofta kallat gold answer, är ”Chief of Protocol”, protokollchef. Exemplet anger också att dokumentet blir 15 sidor vid 10x, vilket vår renderare återskapade.7 Dokumentet ryms även som text. Det låter oss undersöka metoden utan att kontextfönstrets kapacitet sätter gränsen.
Apples publicerade utvärdering använder vLLM på en nod med åtta B200-GPU:er. Våra mätningar nedan gäller den kvantiserade MLX-konverteringen på en enda vanlig Mac.
Vad en sida kostar
Text tar plats i modellens kontext som token, ofta ord eller delar av ord. Bilder omvandlas till bildtoken som också tar plats. Vi räknade båda med modellens processor, efter att den hade tillämpat chattmallen och omvandlat varje bild till de token modellen tar emot.
Tabellen skiljer dokumentet från samtalet runt det. ”Enbart dokumentet” drar bort samma korta prompt från varje representation. ”Första anropet” omfattar Apples verktygsinstruktioner och den faktiska frågan. ”Andra anropet” innehåller även modellens första svar och sidtexten den bad om.
| Representation | Enbart dokumentet | Första anropet | Andra anropet |
|---|---|---|---|
| Ren text | 7 932 | 8 123 | ej tillämpligt |
| Sidbilder, 5x | 1 416 | 1 607 | 2 298 |
| Sidbilder, 10x | 738 | 929 | 1 784 |
| Sidbilder, 15x | 530 | 721 | 1 354 |
Alla värden är antal token. Anropens värden beskriver indata till varje generering, inte det sammanlagda arbetet eller den högsta minnesanvändningen. Prompten med ren text räknades, men kördes inte genom modellen.
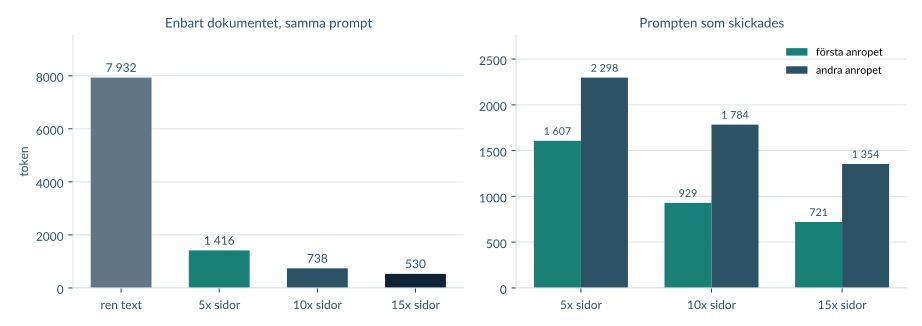
Till vänster: enbart dokumentet, med samma omgivande prompt för text och bilder. Till höger: prompterna testkoden skickade vid första anropet och vid det andra, efter att modellen hämtat en sidas text. Antalen kommer från modellens processor tillämpad på testkodens egna meddelandelistor.8
Vid 10x tar dokumentet 738 token som bilder, jämfört med 7 932 som text: ungefär en tiondel av utrymmet. Hela prompten till det andra anropet växer till 1 784 token när samtalet och den begärda sidan räknas med. Det är fortfarande ungefär 4,6 gånger mindre än textpromptens 8 123 token, men det är en annan jämförelse än den som bara gäller bilderna.8
De 738 token består av 708 bildtoken och 30 avgränsare som markerar de 15 bilderna. Genomsnittet är 47,2 bildtoken per sida. Apple anger 48 för en hel sida vid 10x; vår kortare sista sida drar ned snittet. Samma skillnad finns vid de andra lägena: våra genomsnitt är 68,8 och 23,2, mot Apples 72 och 24 för hela sidor.1
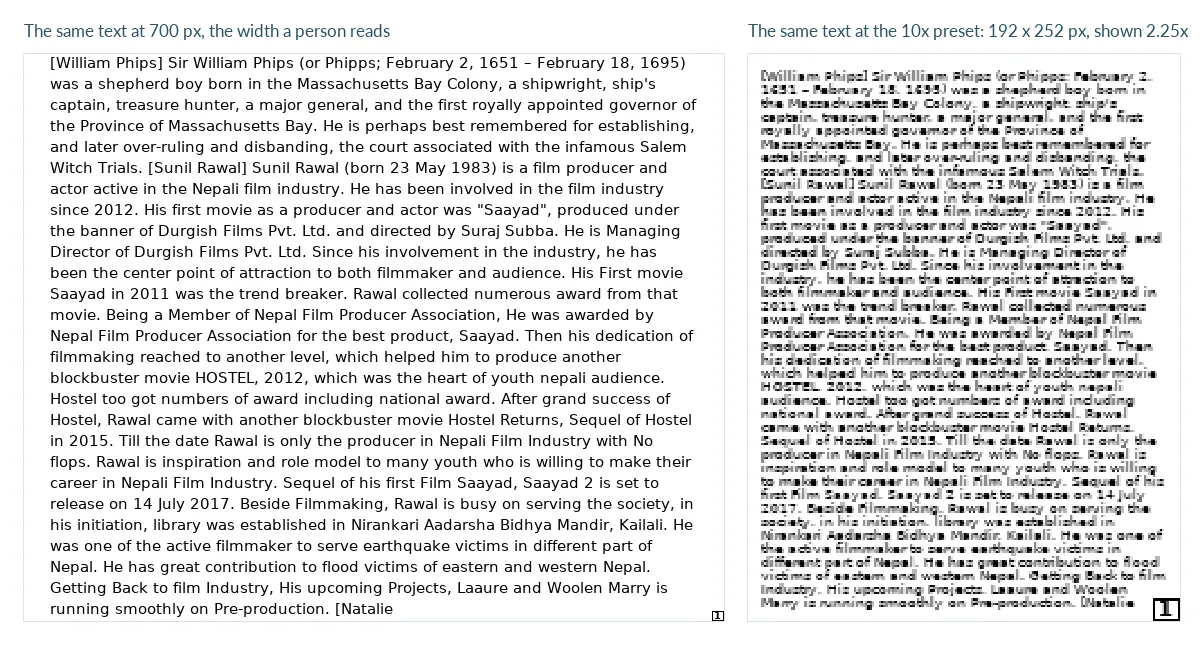
Samma text i två upplösningar. Vid 10x är en sida 192 pixlar bred med en teckenstorlek på 6 pixlar. Den högra bilden är förstorad för artikeln; modellen ser den mindre versionen.
En detalj att lägga märke till: högre komprimering betyder inte färre sidor. Dokumentet behöver 20 sidor vid 5x, 15 vid 10x och 21 vid 15x, eftersom ett läge ändrar både upplösningen och hur mycket text som ryms på en sida. Läget 10x gav färst sidor här, medan 15x använde färst token. Ingetdera är en allmän regel, så mät dokumentet du har.
Hittar den fortfarande svaret?
Vi körde hela loopen i alla tre lägen: granska de komprimerade sidorna, anropa
read_page när modellen ber om det och låt den svara.9 Verktygssvaret
innehåller den verkliga sidtexten, så modellen får arbeta med källdokumentets
ord på den sida den väljer.
| Läge | Granskade sidor | Hämtad sida | Hämtad sidtext | Första anropet | Andra anropet | Innehåller referenssvaret |
|---|---|---|---|---|---|---|
| 5x | 20 | 13 | 1 687 tecken | 21,4 s | 23,6 s | ja |
| 10x | 15 | 10 | 2 192 tecken | 17,0 s | 18,7 s | nej |
| 15x | 21 | 14 | 1 576 tecken | 14,1 s | 8,4 s | ja |
Alla tre körningar öppnade den relevanta sidan och avslutades efter två anrop. De fick mellan 1 576 och 2 192 tecken som hämtad text, av dokumentets 32 033, tillsammans med bilderna av samtliga sidor. Tiderna är förfluten tid på vår dator, med modellen redan inläst och greedy-avkodning, där det mest sannolika alternativet väljs i varje steg. Bildbearbetningen ingår.10
Vid 10x valde modellen sida 10, samma som i Apples publicerade exempel. Där identifieras Shirley Temple och flera statliga befattningar räknas upp: USA:s ambassadör i Ghana, ambassadör i Tjeckoslovakien och protokollchef i USA. Vår 10x-körning svarade med ambassadörsposterna, 5x-körningen med ”Chief of Protocol of the United States” och 15x-körningen med båda.
Frågan ber om en statlig befattning utan att precisera vilken. Svaret vid 10x har stöd på sidan även om det inte innehåller referenssvarets text. Att hitta underlaget och att matcha ett referenssvar är två olika kontroller. Här är den senare en bokstavlig strängmatchning, inte en bedömning att det andra svaret är fel.
Ett dokument och en fråga kan inte avgöra svarskvaliteten. De visar däremot att samspelet fungerar: granska bilderna, välj en sida, läs dess källtext och svara, utan att bygga ett sökindex eller läsa in hela dokumentet som text.
Färre token är inte kortare väntan
Mindre kontext är inte samma sak som ett snabbare svar. Den avvägningen är värd att förstå innan man använder metoden. Apples effektivitetsbilaga mäter den: med en vanlig körning som hämtar texten från en sida behöver LensVLM två anrop i följd, totalt cirka 17 sekunder mot cirka 8 för textalternativets enda anrop. Det är ungefär dubbla väntetiden vid batchstorlek ett och 256 genererade token på B200-hårdvara.11
Det har två orsaker. Varje hämtning kräver en omgång generering följd av ny inläsning av kontext, och de kan inte köras parallellt. Dessutom måste varje renderad sida passera bildkodaren innan språkmodellen ser något, ett arbete som textalternativet helt slipper. Vinsten ligger i stället i minnesbehov och hur mycket av dokumentet som ryms: i samma bilaga tar 20 sidor vid 15x upp 2 288 token efter alla texthämtningar, mot 10 686 för textalternativet. Det motsvarar 78,6 procent mindre utrymme i nyckel/värde-cachen när den är som störst, och 84,2 procent vid 100 sidor.
Våra Mac-körningar tog 22,5 till 45 sekunder över de två anropen. Vi tog inte tid på ett alternativ med hela dokumentet som text på Macen. Körningarna visar därför inte om metoden är snabbare eller långsammare lokalt. Den uppmätta besparingen gäller promptens storlek; Apples separata experiment visar varför det inte behöver innebära kortare väntan.
Vad vi tar med oss
Komprimeringen väljs före körningen. Sidans geometri bestämmer det inledande behovet av bildtoken. Man behöver inte känna till frågan för att välja läge, men det slutliga samtalet växer beroende på vilka sidor modellen öppnar. Räkna med båda delarna när du bedömer hur stort kontextfönster som behövs.
Den ursprungliga texten finns kvar. Den här loopen behöver inget index av textinbäddningar. Modellen ser varje sida i komprimerad form och kan be om orden bakom en lovande bild. Apples analys visar att modellen vid högre komprimering förlitar sig mer på den hämtade texten och mindre på sin egen läsning av de små bilderna.1
Den tränade läsaren är lika viktig som de små bilderna. Apples renderingsstudie jämförde tre sidformat vid ungefär samma komprimering. Basmodellens träffsäkerhet varierade med 18 procentenheter; varianter som tränats för respektive format skilde sig bara en halv procentenhet. Bildkodaren var fryst under träningen. Att enbart krympa sidor ger inte samma beteende hos en godtycklig bild- och språkmodell.1
Vad vi inte mätte
Vi återskapade inte Apples jämförelsetabell. Deras resultat omfattar sju tester av textbaserade frågor och svar, bedömda av en modell med 397 miljarder parametrar. Våra omfattar ett dokument på en dator. De bör inte jämföras.
Vi använde en fyrabitarskonvertering. Fördelningen av bitar mellan modellens lager hämtades från en annan modell och mättes inte fram för den här. Dess dokumenterade bildtester använder enkla former. Våra körningar prövar komprimerade dokumentsidor, men mäter inte hur mycket av kvaliteten konverteringen bevarar. Vi skilde heller inte effekterna av kvantisering från effekterna av en annan körmiljö. Det skulle kräva en jämförelse med bfloat16-vikterna och referensimplementationen.
Vi har inte testat svenska dokument, vilket spelar större roll för oss än för många av våra läsare. De publicerade textutvärderingarna är på engelska. Den komprimerade sidan är en bild av den text man renderar, även när prickar och ringar över bokstäver ska rymmas i fem pixlars höjd.
Slutsats
Frågan vi började med var om en mindre vy kunde hålla underlaget inom räckhåll. I det här exemplet gick det: vid 10x tog femton sidbilder 738 token, och modellen bad om sidan som innehöll svaret. Prompten till det andra anropet, med texten och samtalet inräknade, använde 1 784 token mot textalternativets 8 123.
Det ger oss en konkret metod att undersöka när ett dokument börjar fylla kontextfönstret: behåll en överblick av alla sidor och lägg sedan mer kontext på underlaget som behöver det. Att pröva metoden i verkligt arbete innebär att mäta svarskvalitet, hela samtalet och väntetiden, med ett sökbaserat alternativ eller hela dokumentet som text att jämföra med. Vårt enda exempel kan inte avgöra vilket som passar bäst, och LensVLM:s forskningslicens är fortfarande en separat begränsning.
Det som stannar kvar är hur uppmärksamheten fördelas. En liten vy kan hjälpa oss att hitta rätt sida; de ursprungliga orden finns kvar när det är dags att läsa.
Fotnoter
-
Xie, Friedman, Yu, Pan, Fifty, Kim, Du, Gan, Rathod och Dhingra, LensVLM: Selective Context Expansion for Compressed Visual Representation of Text, arXiv 2605.07019, inskickad den 7 maj 2026. Sammanfattningen rapporterar träffsäkerhet jämförbar med fulltextalternativet vid 4,3 gångers effektiv komprimering och resultat över sökbaserade, textkomprimerande och bildkomprimerande jämförelsemetoder upp till 10,1 gånger på sju tester av textbaserade frågor och svar. Båda siffrorna gäller komprimering, inte hur många gånger högre träffsäkerheten är. ↩ ↩2 ↩3 ↩4
-
Apple, modellkortet för apple/LensVLM-9B, publicerat den 21 september 2026. Det dokumenterar verktyget
read_page, komprimeringslägena 5x, 10x och 15x samt modellens grundarkitektur. ↩ -
Apple, apple-aiml-research/ml-lensvlm vid commit
10709a7. Komprimeringslägena finns ilensvlm/rendering_config.py, systemprompten för verktygsanrop ilensvlm/prompts.pyoch loopen för flera anrop ilensvlm/evaluate.py. Demonstrationsskripten importerar vLLM. ↩ -
Apple Machine Learning Research Model License, läst den 24 september 2026. Tillståndet är begränsat till forskning och kan återkallas. Koden i repot släpps under Apple Sample Code License. ↩
-
Datoruppgifter, låsta versioner och installationskommandon: README.txt i det nedladdningsbara underlaget. Datorn är en Apple M4 med 24 GB enhetligt minne och macOS 26.6.2, med Python 3.12, mlx-vlm 0.7.2 och mlx 0.32.2. ↩
-
mlx-community/LensVLM-9B-OptiQ-4bit, revision
9e3d1de1d65ed7a301cdeed4b58e70a461a02463. Publicerad den 24 september 2026, cirka 7,1 GB för språkdelen och 0,9 GB för bilddelen i en separat fil. Modellkortet anger att fördelningen av bitar mellan lagren hämtades från Qwen3.5-9B-konverteringen och inte mättes fram för den här modellen. ↩ -
Precisit, kontroll av renderingen. Det medföljande exemplet anger 15 sidor vid 10x; vår körning gav samma antal. Hela sidor är 192 gånger 252 pixlar, med en kortare sista sida på 192 gånger 198. Filen redovisar sidantal och storlekar för alla tre lägena. ↩
-
Precisit, uppmätt tokenkostnad. Värdena för enbart dokumentet drar bort samma omgivande prompt på 27 token från varje representation. Anropens värden använder Apples systemprompt och den faktiska frågan. Till det andra anropet läggs det registrerade första svaret och verktygssvaret. Räknaren använder testkodens funktioner för att bygga meddelanden och modellens processor. Det är indatalängder före generering, inte en mätning av nyckel/värde-cachens största minnesbehov. ↩ ↩2
-
Precisit, nedladdningsbart underlag (ZIP), med den portabla MLX-testkoden, två mätskript, råloggar och alla JSON-filer som hänvisas till här. Testkoden anpassar referensloopen till mlx-vlm-generering och importerar Apples renderare, prompter och funktioner för att tolka verktygsanrop och plocka ut svar. ↩
-
Precisit, körprotokoll och samma tabell som CSV. Greedy-generering använde en gräns på 1 024 nya token per anrop och ingen särskild stoppsekvens. Varje registrerat anrop avslutades under gränsen, det längsta efter 188 token. Apples demonstration stoppar vid verktygsanropets avslutande tagg; vår testkod förlitar sig på modellens token för slutet av ett svar. Modellinläsning ingår inte i tiderna. Arkivet innehåller råloggar och en portabel kopia av testkoden, med senare ändringar för installation och körning dokumenterade. ↩
-
Samma artikel, effektivitetsanalys och begränsningar. Tidsjämförelsen använder en texthämtning, batchstorlek ett, 256 genererade token och B200-hårdvara. Antalen token beskriver det största utrymmet i nyckel/värde-cachen vid sista anropet, mätt genom vLLM med tensorparallelism 8 på 20 och 100 indatabilder. ↩