M5 Pro mot M4 Pro: vad en ny Mac mini gav vid träning
Vi flyttade ett träningsjobb från Mac mini M4 Pro 64 GB till M5 Pro 64 GB: 13 till 15 procent snabbare träning, ungefär 20 procent snabbare generering och oförändrad minnesåtgång.

Kapitel
De flesta mätningar av en ny Mac handlar om hur snabbt den svarar. Färre handlar om hur snabbt den lär sig. Den andra frågan spelar roll när arbetet på den egna datorn är att träna en modell snarare än att chatta med en.
Vi hade ett träningsjobb att flytta, så vi mätte både träning och generering på två Mac mini: den M4 Pro med 64 GB som arbetet dittills hade körts på, och den M5 Pro med 64 GB som ersatte den den 24 september.
Med samma träningsupplägg, data, slumpfrö och startvikter var M5 Pro 1,15× så snabb som M4 Pro per träningssteg. För hela jobbet var förhållandet 1,14×: 1 800 steg tog 2 h 35 min där M4 Pro behövde 2 h 55 min. Generering från samma sparade modell gick ungefär 1,2× så snabbt, och minnesåtgången var oförändrad. Båda datorerna har 20 GPU-kärnor.
En annan jämförelse satte vinsten i perspektiv. På M5 Pro fördubblades beräkningshastigheten i en fristående matrismultiplikation när vi ändrade precisionsinställningen. Ändå blev ett träningssteg bara ungefär 3 procent kortare. En snabbare beräkning gör inte nödvändigtvis hela jobbet lika mycket snabbare.
Jobbet vi flyttade
Arbetet gäller en språkmodell med 123 miljoner parametrar som kombinerar rekurrenta lager (gated linear attention) med lager med full attention och ett mixture-of-experts-MLP. Vi tränar den i MLX med AdamW, en batch på 4 × 1 024 token, omberäkning av lager för att spara minne och en utmatningsdel som beräknas i block.
Steget vi mätte är finjustering: 1 800 träningssteg från en förtränad, sparad modell på en blandning av uppgifter för verktygsanvändning och kopiering.
Det är ett litet jobb som vi kan köra flera gånger på datorerna vi har. Det visar vad just den här modellen vinner, inte vad en större modell skulle vinna.
Vad vi jämförde
| Mac mini M4 Pro | Mac mini M5 Pro | |
|---|---|---|
| Modellidentifierare | Mac16,11 | Mac17,16 |
| CPU | 14 kärnor | 18 kärnor |
| GPU | 20 kärnor, Metal 4 | 20 kärnor, Metal 4 |
| Minne | 64 GB enhetligt minne | 64 GB enhetligt minne |
| macOS | 26.5 (25F71) | 27.0 (26A428) |
| Python och MLX | 3.12.13 och MLX 0.32.2 | 3.12.14 och MLX 0.32.2 |
Båda datorerna körde samma MLX-paket. Metal-biblioteket i paketet har samma SHA-256 på båda, så de använde samma binärfil.
I den kontrollerade jämförelsen körde M5 Pro M4 Pro-datorns träningsupplägg i 20 steg: samma dataordning, samma slumpfrö och samma startvikter. Vi valde full float32-precision på M5, som vi beskriver nedan. Tider och minnesåtgång för de fullständiga körningarna kommer från loggade mätvärden. Matristesterna var separata mätningar.1
Vad datorerna presterade
| Mätning | M4 Pro | M5 Pro | Hastighetsökning |
|---|---|---|---|
| Sekunder per träningssteg, hela körningen på 1 800 steg | 5,543 | 4,888 | 1,13× |
| Sekunder per träningssteg, samma data, slumpfrö och vikter (steg 2 till 19) | 5,547 | 4,832 | 1,15× |
| Hela träningsjobbet | 10 527 s (2 h 55 min) | 9 270 s (2 h 35 min) | 1,14× |
| Genereringskontroll efter träningen, 400 promptar | 210,3 s | 176,3 s | 1,19× |
| Validering på en fast delmängd | 14,6 s | 12,4 s | 1,18× |
| Generering från samma sparade modell, 400 promptar | 192,7 s | 157,9 s | 1,22× |
| Hela utvärderingen, fyra delmoment inklusive modellinläsning | 315 s | 257 s | 1,23× |
| Högsta minnesåtgång under träning | 9,42 GiB | 9,44 GiB | oförändrad |
För tiderna är hastighetsökningen M4-tiden delad med M5-tiden. Förhållandet 1,15× betyder ungefär 15 procent mer arbete per sekund, eller ungefär 13 procent kortare tid.
Raden för hela träningskörningen jämför samma dimensioner och inställningar på olika träningsdata. Av träningsraderna är det bara jämförelsen med 20 steg som har samma data, slumpfrö och startvikter. Den andra M5-körningen tog 4,846 i stället för 4,832 sekunder per steg, en skillnad på ungefär 0,3 procent. Båda stöder samma slutsats.
Ytterligare en detalj spelar roll för ett litet jobb. Tiderna per träningssteg är inte särskilt utspridda: i den fullständiga körningen låg M4 Pro mellan 5,45 och 5,65 sekunder från den 10:e till den 90:e percentilen, och M5 Pro mellan 4,82 och 4,96. Intervallen överlappar inte. De beskriver variation inom varje körning, inte konfidensintervall över upprepade jobb.
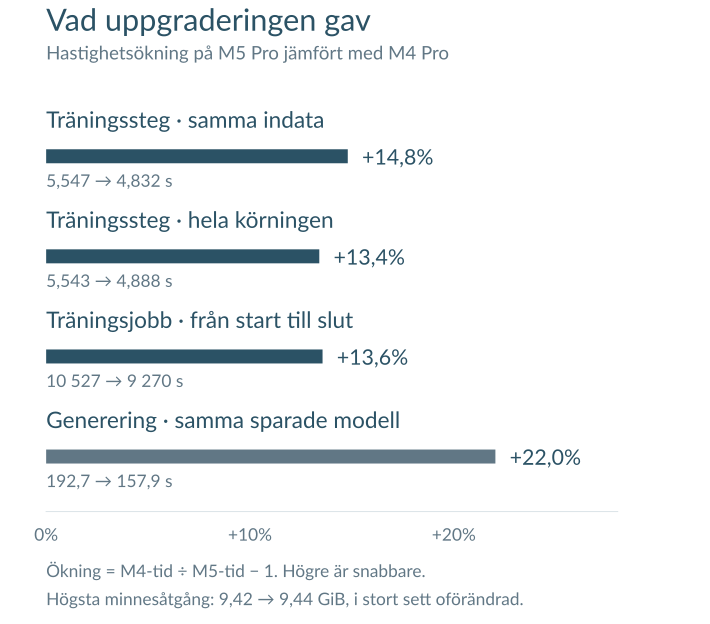
Hastighetsökningen beräknas som M4-tid delad med M5-tid, minus ett. De fullständiga träningsjobben använde olika data med samma dimensioner och inställningar. Den korta jämförelsen använde samma indata. Minnesåtgången var i stort sett oförändrad.
Varför träningen vinner mindre än matristesterna
En float32-matrismultiplikation på 2 048³ nådde 4 433 GFLOP/s på M4 Pro och 5 736 GFLOP/s på M5 Pro, ungefär 1,29×. Med M5 Pro-datorns standardinställning, som sänker precisionen, blev resultatet 11 548 GFLOP/s, ungefär 2,6× M4 Pro-datorns hastighet med full precision.
M4-värdet kom från ett tidigare test vid installationen, med ett annat mätprogram. Jämförelserna mellan datorerna ger därför en ungefärlig bakgrund. Den tydligare jämförelsen är inom M5: standardinställningen fördubblade hastigheten i matristestet, men kortade ett träningssteg med bara ungefär 3 procent.
Vår tolkning är att den snabbare matrisberäkningen bara täcker en liten del av arbetets totala tid. Rekurrenta lager, minnestrafik och arbetet med att starta varje operation är tänkbara bidrag. Matriserna i träningen skiljer sig också från det stora fristående testet. Vi har inte profilerat de bidragen var för sig.
Den praktiska slutsatsen är att ett hastighetsförhållande från ett matristest inte förutsäger träningsvinsten. Större modeller eller batcher skulle kunna utnyttja matrishårdvaran bättre, men det återstår att mäta. Det är inget resultat från den här jämförelsen.
En precisionsinställning att känna till på M5
När vi kontrollerade den nya datorn hittade vi något som en M5-ägare bör känna till innan resultat jämförs mellan Mac-datorer.
På M5 Pro kör MLX 0.32.2 den float32-matrismultiplikation vi testade med sänkt
precision som standard. Miljövariabeln MLX_ENABLE_TF32 har standardvärdet
1. Värdet 0 begär full float32-precision.2 MLX-dokumentationen beskriver
familjen av matrismultiplikationsoperationer, inklusive attention. Vilka som
berörs beror på MLX:s backend och hårdvaran. En av utvecklarna bekräftar
också att flaggan aktiverar TF32 när beräkningsvägen via neuralacceleratorerna,
NAX, stöder operationen.3
Vårt M1 Max-test gav oförändrat resultat när vi växlade flaggan. M4 Pro-körningarna
loggade värdet 1, men deras resultat stämde med M5 i fullprecisionsläget. Samma
flaggvärde betydde alltså inte samma aritmetik på de två datorerna.
För tät float32-matrismultiplikation väljer 0 en GPU-implementation med full
precision utanför NAX. Operationen fortsätter alltså inte på NAX med högre
precision. FP16- och BF16-operationer kan fortfarande använda NAX, så flaggan
stänger inte av acceleratorerna generellt.4
Det här mätte vi på M5 Pro:
| Sänkt precision (standard) | MLX_ENABLE_TF32=0 | |
|---|---|---|
| float32-matrismultiplikation, 2 048³ | 11 548 GFLOP/s | 5 736 GFLOP/s |
| Relativt fel mot float64, 1 024³ | 8,2e-4 | 1,5e-6 |
Feltestet använde en mindre matris än hastighetstestet. Måttet är den största absoluta avvikelsen delad med det största absoluta referensvärdet.
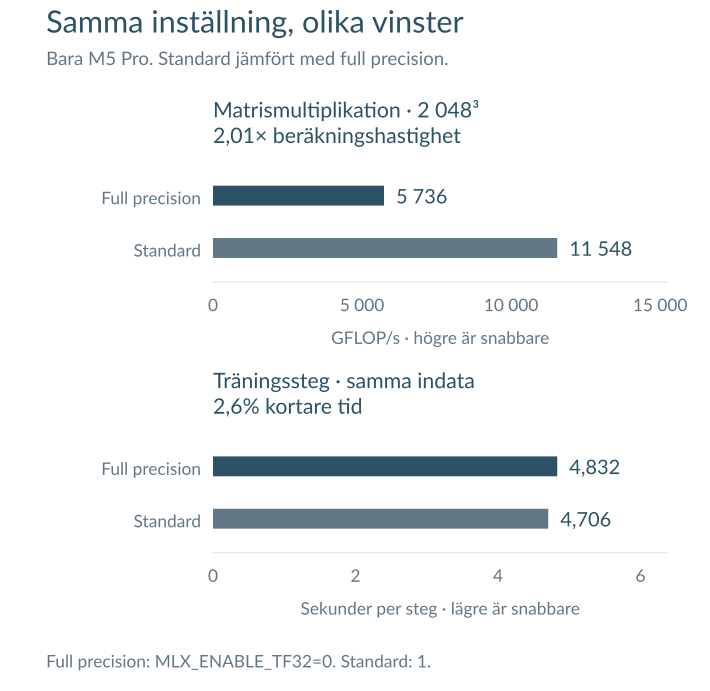
Båda jämförelserna gäller M5 Pro. Standardinställningen fördubblar hastigheten i matristestet, medan ett träningssteg med samma indata tar ungefär 3 procent kortare tid. Staplarna börjar vid noll. Varje diagram anger enhet och om högre eller lägre är snabbare.
Kostnaden för att stänga av den sänkta precisionen är verklig men liten: ungefär 3 procent på det här träningsjobbet på M5. Att lämna den på ändrade de numeriska resultaten. Med standardinställningen ändrades 9 av 1 600 utdata när vi utvärderade en sparad modell på nytt. Loggsannolikheter flyttades med upp till 0,56 nats, och träningsförlusten avvek från M4 Pro redan vid det första steget, med 2,6e-4.
Med MLX_ENABLE_TF32=0 återskapade M5 Pro M4 Pro-datorns utvärderingsresultat
bit för bit. Av de första 20 träningsförlusterna var 16 bitidentiska och resten
skilde sig med mindre än 1e-6. Full precision återställde exakt överensstämmelse
för de testade utvärderingsresultaten och nära överensstämmelse för träningen.
Det gav oss en stadigare grund för att jämföra tiden varje dator behövde.
Det fanns en praktisk fallgrop: vårt träningsprogram skrev till en början över värdet som begärdes i skalet. Vi upptäckte skillnaden i körningens logg och rättade konfigurationen innan vi mätte tiderna med full precision ovan. För oss hör inställningen nu hemma i varje körnings dokumenterade miljö. Kontrollera vad processen faktiskt använde, inte bara vad startkommandot begärde.
När standardinställningen passar
Att behålla MLX_ENABLE_TF32=1 kan vara en användbar avvägning för snabbare
inferens i vardagen eller för träning, förutsatt att kontroller av den aktuella
modellen visar godtagbar kvalitet och, vid träning, konvergens. Sänkt precision
betyder inte i sig sämre svar, och träning kräver inte automatiskt att flaggan
är avstängd.
Vi valde 0 för att jämföra det numeriska beteendet med den äldre datorn.
Det är också användbart vid referensberäkningar och felsökning av små
skillnader. Standardinställningen erbjuder fart; arbetsuppgiften avgör om
avvägningen är värd det. Kostnaden på ungefär 3 procent gäller det här jobbet,
inte full precision i allmänhet.
Vad resultaten inte säger
- Det är ett arbetsflöde med en modellstorlek. Det här är inget allmänt chiptest. Det säger inget om inferens med stora modeller eller om träning som behöver mer av de 64 GB än det här jobbet gör.
- Datorerna skiljer sig åt på fler sätt än chippet. De körde olika macOS-versioner, 26.5 respektive 27.0. Antal GPU-kärnor, minneskapacitet och MLX-paket matchar, men jämförelsen kan inte skilja operativsystemets bidrag från chippets.
- En eller två körningar per mätpunkt. Vi skulle inte dra slutsatser av skillnader under 1 eller 2 procent i de här siffrorna.
- Inget här mäter modellkvalitet. Vi mätte tid, inte om modellen blev bättre på sin uppgift.
Så mätte vi
| Inställning | Värde |
|---|---|
| Modell | Hybridspråkmodell med 123 miljoner parametrar och ett mixture-of-experts-MLP |
| Träningsfas | Finjustering, 1 800 steg från en förtränad, sparad modell |
| Batch | 4 × 1 024 token |
| Optimerare | AdamW |
| Ramverk | MLX 0.32.2, Python 3.12.13 (M4 Pro) och 3.12.14 (M5 Pro) |
| Kontrollerad jämförelse | 20 steg, samma träningsupplägg, dataordning, slumpfrö och startvikter |
| Minneshantering | Omberäkning av lager och en utmatningsdel som beräknas i block |
| Precision | Full float32 i praktiken; M4 loggade MLX_ENABLE_TF32=1, M5 loggade 0 |
Mätvärdena är avskrivna från körningarnas loggar och separata matristester. Träningsdata, den sparade modellen och körningsloggarna är interna, så källanteckningen är inte offentlig. Mätunderlaget listar de exakta värdena bakom tabellerna ovan. Det går alltså att kontrollera beräkningarna utan tillgång till våra datorer.1
Vad vi tar med oss
Om frågan är om den nya Mac mini-datorn gjorde träningen av vår lilla modell snabbare är svaret ja. M5 Pro gav oss 13 till 15 procent snabbare träning och ungefär 20 procent snabbare generering, med samma minnesåtgång och samma 20 GPU-kärnor. Hela jobbet blev klart ungefär 21 minuter tidigare. Det är användbar tid för ett nytt försök, även om jämförelsen inte kan skilja chippets bidrag från de olika macOS-versionernas.
Om frågan är hur mycket en snabbare matrisberäkning hjälper det här träningsjobbet är svaret betydligt mindre än det fristående testet antyder. På M5 fördubblade standardprecisionen hastigheten i matristestet, men kortade ett träningssteg med bara ungefär 3 procent. Arbetet avgör hur mycket av hårdvarans försprång som blir sparad tid.
Och om du jämför float32-beräkningar mellan Mac-datorer, kontrollera
precisionsläget först. För det här jobbet kostade MLX_ENABLE_TF32=0 på M5
några procent och fick de numeriska resultaten att stämma nära överens igen. En
användbar jämförelse börjar med att veta vad datorerna faktiskt räknade ut.
Fotnoter
-
Mätunderlag (JSON, engelska). Tider, minnesåtgång, precisionskontroller och matristester för Mac mini M4 Pro 64 GB (Mac16,11) och Mac mini M5 Pro 64 GB (Mac17,16), med båda de korta M5-körningarna bevarade. Det är en avskrift av mätningarna, inte ett offentligt paket för att återskapa experimentet. ↩ ↩2
-
MLX v0.32.2,
mlx/utils.h, därMLX_ENABLE_TF32har standardvärdet1, och Numerical Precision, som beskriver hur full precision väljs och hur beteendet beror på hårdvaran. ↩ -
ml-explore/mlx, issue 3235. En utvecklare svarade den 10 mars 2026 att TF32 stöds av NAX och att flaggan aktiverar det när det är tillgängligt för operationen. Ärendet stängdes samma dag. ↩
-
MLX v0.32.2,
matmul.cpp. Villkoretuse_naxkräverenable_tf32()för float32-indata. Det här beskriver vägvalet i källkoden, inte en hårdvaruspårning av hela vårt träningsjobb. ↩