En millisekund för att välja ett drag
Vår AI kunde redan spela fyra i rad. En liten WebGPU-körmiljö gjorde dragen snabbare och nedladdningen mindre. Sedan tog en människa en tankepaus.

Kapitel
Tretton millisekunder är ingen lång väntan på en motståndare. De flesta av oss behöver längre tid bara för att märka vems tur det är. Men en liten AI-modell kommer med mer än sina inlärda vikter: webbläsaren behöver också programvaran som kör den. Den koden ska laddas ned, startas och samsas med allt annat på sidan.
I vår första artikel om fyra i rad tränade vi en liten modell som poängsätter de tillåtna kolumnerna i ett enda framåtpass, utan att söka igenom framtida ställningar. Den här gången behöll vi den tränade modellen och arbetade med dess körmiljö. Kunde vi göra ett lokalt beslut billigare att leverera, inte bara snabbare att fatta?
På en M5 Pro utan annan belastning, i Chrome, tog uppvärmda drag med int8-modellfilen på 7,8 MB ungefär 1 ms i vår WebGPU-körmiljö, jämfört med 12,7 ms i ONNX Runtime Webs enkeltrådade WebAssembly-backend. Körmiljöns kod krympte från 14,3 MB till 37 KB, före nätverkskomprimering. Modellfilen tillkommer i båda fallen.1
De små siffrorna var tillfredsställande. Den mer användbara lärdomen kom när en människa stannade upp för att tänka mellan dragen.
Prova hastighetsjämförelsen i din webbläsare. Spela ett parti och kör sedan prestandatestet. Jämförelsetabellen samlar nedladdningsstorlek, starttid och tid per drag, med bästa värdet i blått och sämsta i rött. Diagrammet visar hur mycket betänketiden varierar på din dator.
En mindre motor för samma AI
En körmiljö läser modellens lagrade tal och utför dess beräkningar. ONNX Runtime Web är ett generellt verktyg för många sorters modeller. Vår öppna onepass-webgpu hanterar en enda familj: modellerna som poängsätter handlingsalternativ i våra OnePass-experiment.
Modellen läser brädet och de tillåtna kolumnerna och returnerar sju poängvärden. Dess exporterade ONNX-graf innehåller ungefär tusen noder, inklusive allt som flyttar data och ändrar dess form. Våra verktyg känner igen de underliggande lagren. Körmiljön läser deras vikter ur den oförändrade filen och kör ett litet antal GPU-kernels. En kernel är ett kort program som många GPU-trådar kör parallellt. Här är de beräkningsshaders skrivna i WGSL. WebGPU är webbläsarens API för att skicka arbetet till GPU:n och hämta resultaten. Dessa shaders räknar ut poäng i stället för att rita bilder.2
Den smalare uppgiften gör motorn liten. Den sätter också dess gräns: en modell som inte känns igen avvisas, i stället för att behandlas som en ONNX-graf som stöds.
I tidstestet poängsatte varje motor samma 500 ställningar efter 20 uppvärmningsdrag. Vi upprepade körningen tre gånger på en Apple M5 Pro utan annan belastning, med 20 GPU-kärnor, Chrome 154 och dess riktiga Metal-GPU. Tidtagningen börjar när indata skickas till motorn och slutar när alla sju poängvärden är tillbaka i JavaScript. Tiderna gäller uppvärmda körningar, inte sidans laddning.3
| Körmiljö och vikthantering | Storlek | Median | 95:e p. |
|---|---|---|---|
| ONNX Runtime Web, WebAssembly, fp32 | 29,7 MB | 12,2 ms | 12,3 ms |
| ONNX Runtime Web, WebAssembly, int8 | 7,8 MB | 12,7 ms | 12,9 ms |
| onepass-webgpu, fp32-vikter | 29,7 MB | 1,3 ms | 1,4 ms |
| onepass-webgpu, fp16-vikter | 29,7 MB | 0,9 ms | 1,1 ms |
| onepass-webgpu, int8-vikter | 7,8 MB | 1,0 ms | 1,1 ms |
Den 95:e percentilen är den tid som 95 procent av de uppmätta dragen klarade sig inom. Alternativet fp16 konverterar fp32-filens vikter vid inläsning och minskar därför inte nedladdningen. Tabellen visar medianen av de tre körningarnas medianer respektive 95:e percentiler.1
WebAssembly-referensen använde ONNX Runtime Web 1.30 utan cross-origin isolation, precis som demot på GitHub Pages. Den kördes därför med en enda tråd. Det är den webbläsarkonfiguration vi mätte; en sida som är konfigurerad för flera WebAssembly-trådar är en annan jämförelse.4
Resultatet på ungefär 20 ms i vår första artikel kom från en M1 Max. Här körs båda körmiljöerna på samma M5 Pro. Vi räknar alltså inte ett datorbyte som en förbättring av körmiljön.
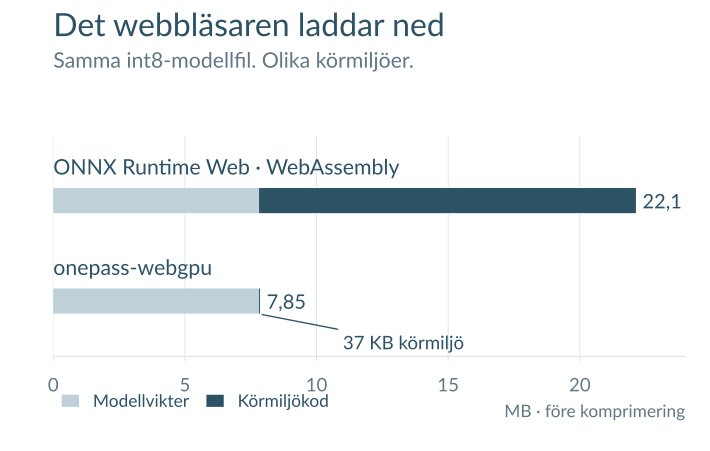
Den specialiserade körmiljön är ungefär 380 gånger mindre före komprimering. Med gzip är dess kod ungefär 12 KB, jämfört med cirka 3,7 MB för referensens körmiljö. Lägg till modellfilens 7,8 MB i båda fallen: en mindre motor får inte vikterna att försvinna. Jämförelsedemot använder en tidigare version på 24 KB. Den uppmätta versionen på 37 KB kan också läsa ONNX direkt i webbläsaren.1 Jämförelsesidan laddar medvetet flera motorer och båda modellfilerna så att du kan mäta dem sida vid sida.
Snabbare, men väljer den samma drag?
För fp32 kontrollerade vi samtliga 17 325 utvärderingsställningar genom demots egen kodning och körmiljö. Alla 17 325 valda kolumner stämde med ONNX Runtimes fp32-referens. Poängen skilde sig lite. Den största absoluta skillnaden var ungefär 0,000066. Med fp16-vikter ändrades tre val, i ställningar där poängen låg mycket nära varandra.5
För int8 behöver vi vara mer precisa. Samma komprimerade fil kan köras med olika aritmetik. ONNX Runtime kvantiserar även mellanliggande aktiveringar dynamiskt, utöver att använda de kvantiserade vikterna. Vår WebGPU-variant behåller vikterna packade som åttabitarsvärden, packar upp dem inne i matrismultiplikationen och räknar med float32-aktiveringar.
Den väljer därför inte alltid samma kolumn som ONNX Runtimes int8-variant. Den matchade sin egen referens, där bara vikterna är kvantiserade, i alla 17 325 ställningar. Jämfört med den ursprungliga fp32-modellen behöll den samma val i 17 128 ställningar, mot 17 004 för ONNX Runtimes int8-variant. Det mäter överensstämmelse med originalmodellen, inte en ny vinstprocent.6
De packade vikterna tar också mindre GPU-minne: ungefär 7,7 MB i stället för 29,5 MB i det dokumenterade inläsningstestet. Det gäller lagringen av vikterna, inte webbläsarens totala minnesanvändning. Den största tidsskillnaden i tabellen kommer från körmiljön och hur beräkningarna utförs. Lägre precision i vikterna är ett separat val.7
Motståndaren som ibland tänker i sju sekunder
Fyra i rad har redan en mindre och starkare motståndare: en exakt spellösare. Benjamin Ralls MIT-licensierade connect-four-ai spelar perfekt. Dess WebAssembly-paket är ungefär 1,3 MB inklusive en öppningsbok. För en produkt vars enda uppgift är att erbjuda en bra motståndare i fyra i rad är det ett lockande val.
Vi ställde den bredvid modellen i samma webbläsare. Efter två slumpmässiga öppningsdrag spelade lösaren båda sidor optimalt och valde slumpmässigt när flera drag var lika bra. Under 200 partier mätte vi 7 652 ställningar. Varje modellkörmiljö poängsatte sedan exakt samma ställningar. Lösaren behöll sin sökcache inom ett parti och tömde den mellan partierna.8
| Motor, samma 7 652 ställningar | Median | Medel | Långsammast |
|---|---|---|---|
| Exakt lösare, WebAssembly | < 0,1 ms | 40 ms | 6,9 s |
| Modell, onepass-webgpu int8 | 1,0 ms | 0,96 ms | 1,3 ms |
| Modell, ONNX Runtime WebAssembly int8 | 13,1 ms | 13,1 ms | 13,7 ms |
Lösarens typiska drag var snabbare än webbläsarens timer kunde urskilja. Men de långa sökningarna drog upp medelvärdet. Modellens fördel var jämna betänketider, inte att vara snabbast varje gång.
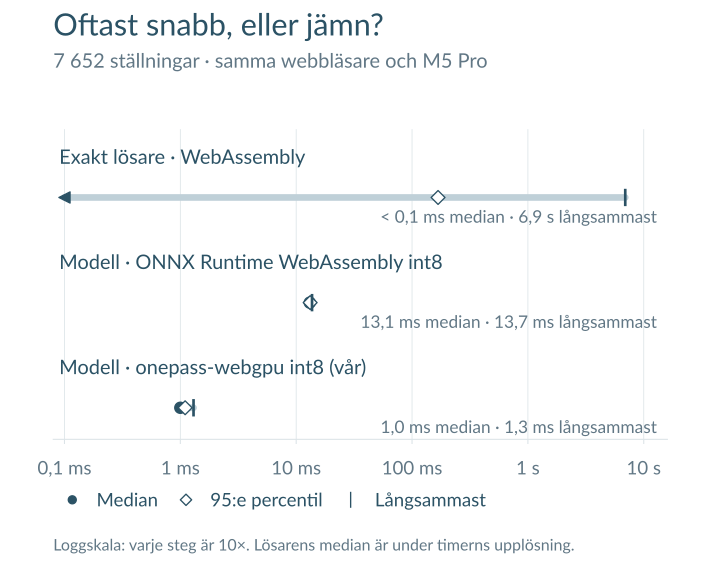
Öppningsboken besvarar många tidiga ställningar billigt, men vissa ställningar efter de slumpmässiga öppningsdragen ligger utanför den. Den långsammaste sökningen, 6,9 sekunder, kom med åtta eller färre brickor på brädet. Den typiska sökningen tog längst tid lite senare: vid nio till tolv brickor var medianen 59 ms. Ännu senare, med få tomma rutor kvar, finns det inte mycket att söka igenom.8
Modellen utför samma beräkning av fast storlek för varje bräde. Det gör arbetsmängden förutsägbar, även om datorn och webbläsaren fortfarande påverkar tiden. Samtidigt saknar den lösarens garanti. Modellen med fp32-vikter valde ett drag som lösaren bedömde som bäst i 91,7 procent av ställningarna. Det är ett annat mått än att bevara en vinst eller remi, och än att vinna ett helt parti.
Det är därför ett löst spel är ett användbart laboratorium. Vi får ett facit för att bedöma ett inlärt beslut, även om den framtida tillämpningen kanske saknar en exakt lösare. I besläktad forskning tränade Ruoss och kollegor transformers på schackställningar märkta av Stockfish och nådde spel på stormästarnivå utan explicit sökning. Den kostsamma läraren gör sitt arbete innan spelaren behöver ett svar.9
GPU:n som inte var en GPU
I en tidig webbläsarkörning såg WebGPU plågsamt långsamt ut: hundratals millisekunder för ett drag. Adaptern visade sig vara SwiftShader, en mjukvaruimplementation som kördes på CPU:n. Vi mätte kostnaden för att låtsas vara en GPU.
I den konfigurationen hade den medföljande webbläsaren utan synligt fönster, i så kallat headless-läge, valt mjukvaruadaptern. Installerad Chrome i sitt nyare headless-läge gav tillgång till den riktiga Metal-GPU:n. Det är en observation om vår testmiljö, inte en regel att headless-webbläsare alltid hamnar på en mjukvaruadapter. Körmiljön kontrollerar nu adaptern och avvisar kända mjukvaruimplementationer som standard.10
Lärdom: Innan du förklarar en överraskande prestandasiffra, ta reda på vad som faktiskt körde beräkningen.
Från MLX-vikter till GPU-kernels i webbläsaren
Två saker ska med från träningen till webbläsaren: de inlärda talen och instruktionerna för att använda dem. De reser tillsammans i ONNX-filen men tar olika vägar när den väl har kommit fram.
Vi tränade med MLX på Apple silicon, kopierade vikterna via NumPy till en motsvarande PyTorch-modell, kontrollerade modellernas resultat och exporterade ONNX från PyTorch. Exportören kontrollerar också de valda dragen mot ONNX Runtime.11
| Steg | Vad förs vidare? |
|---|---|
| MLX → PyTorch | Parametrar med matchande namn och dimensioner |
| PyTorch → ONNX | Graf, vikter och definitioner av in- och utdata |
| ONNX + plan → körmiljö | Lagerkonfiguration och viktarrayer |
| Körmiljö → WebGPU | Buffertar, beräkningspipelines och dispatch-anrop |
| WebGPU → spel | Sju float32-värden, ett per alternativplats |
I mätningarna och demot känner en liten Python-kompilator igen lagren i förväg
och skriver en plan: några kilobyte JSON som namnger vikterna och konfigurerar
modellens kernels. Webbläsaren läser vikterna ur den oförändrade ONNX-filen
och för över dem till GPU-buffertar. Den nyare versionen på 37 KB kan också känna igen
grafen i webbläsaren med Engine.fromOnnx. Testerna ger samma plan för alla
tre publicerade modellfiler. Inläsningen görs en gång, inte inför varje
drag.2
ONNX-filen innehåller modellen. Körmiljön innehåller GPU-programmen som kör
den. Vi översätter inte automatiskt varje ONNX-nod till en shader. De mönster
som stöds väljer handskrivna kernels från
runtime/src/kernels.ts.
Webbläsaren kompilerar WGSL för den underliggande GPU-backenden, Metal på dessa Mac-datorer. Körmiljön skapar och cachar sina pipelines för enskilda drag vid inläsningen och återanvänder dem sedan. Detaljerna i kompileringen beror på webbläsaren och drivrutinen. De rapporterade tiderna gäller uppvärmda körningar.12
För den som bygger med den nyare direktinläsningen ser API:t ut så här:
import { Engine } from "./onepass-webgpu.js";

const bytes = await (await fetch("onepass-c4-v2-int8.onnx")).arrayBuffer();
const engine = await Engine.fromOnnx(bytes);
await engine.wake();
const scores = await engine.score(contextIds, optionIds, optionMask);
De tre indataarrayerna är Int32Array med det kodade brädet, kolumnalternativen
och en mask som anger giltiga alternativplatser. scores är en Float32Array
med sju värden. Demots kodning
visar hur de förbereds. wake() gör en riktig modellkörning med de befintliga
buffertarna. Anropa den före ett beslut, exempelvis medan brickan animeras,
snarare än att räkna det extra arbetet som gratis. Vi återkommer till problemet
med pauser nedan.
Varje drag skriver nya indata och återanvänder sedan cachade pipelines och listan med dispatch-anrop. En bind group kopplar en kernel till dess buffertar. Ett dispatch-anrop anger hur många grupper av GPU-trådar som ska köras. Mellanliggande aktiveringar stannar i GPU-buffertar tills de slutliga poängen kopieras tillbaka.
Ge en liten modell tillräckligt med parallellt arbete
Att nå den riktiga GPU:n var bara början. De första GPU-programmen lämnade för mycket arbete i långa loopar som hanterades av för få trådar. En GPU kan ha gott om räknekapacitet och ändå ägna tiden åt att vänta.
Förbättringen var att dela matrismultiplikationen längs den dimension som summeras. Fler trådar arbetar med kortare delar, och nästa operation lägger ihop delresultaten. Det kallas split-K. Tänk dig att flera personer delar på en lång summa och sedan lägger ihop sina delsummor. Den extra samordningen lönar sig när det ursprungliga jobbet lämnar större delen av gruppen sysslolös.13
Här är den inre loopen i matrismultiplikationens kernel, med mallparametrarna ifyllda för vanliga fp32-vikter:
for (var kk = 0u; kk < KS; kk += 1u) {
  let w = vec4<f32>(W[wi]);
  wi += stride;
  for (var r = 0u; r < RM; r += 1u) { acc[r] = fma(vec4<f32>(at[r * KS + kk]), w, acc[r]); }
}
KS omfattar bara den här gruppens del av den långa summan. Varje tråd
arbetar med fyra utdatakolumner samtidigt genom vec4, och fma multiplicerar
och ackumulerar deras bidrag. RM är fyra rader i den nuvarande
konfigurationen. Aktiveringsblocket at läses in gemensamt till minne som
delas av arbetsgruppens 64 trådar. En barriär ser till att inläsningen är klar
innan loopen börjar. Andra arbetsgrupper tar hand om andra delar av summan.
Nästa operation lägger ihop delsummorna medan den läser sina indata. I
feed-forward-lagren kan samma inläsningssteg också lägga till bias och tillämpa
ReLU. Andra kernels kombinerar residualadditionen med nästa lagernormalisering,
eller summerar delresultat för attention-mekanismens query, key och value
under inläsningen. Genom att slå ihop dessa steg slipper vi separata
dispatch-anrop bara för att sammanställa mellanresultat.
Int8-varianten ändrar hur w läses: fyra packade vikter packas upp ur ett
32-bitarsord, deras nollpunkt subtraheras och skalfaktorn appliceras på det
ackumulerade delresultatet. Aktiveringar och ackumulatorer förblir
float32.13
Uppdelningen har en kostnad: efterföljande operationer måste läsa och addera fler delsummor. Attention upprepar den inläsningen för varje block med åtta queries. Heuristiken balanserar mer parallellt arbete mot dessa läsningar och behåller minst 32 värden av den summerade dimensionen i varje del. Fler delar är inte automatiskt bättre.13
Vi testade avvägningen med fp32-modellen på en M5 Pro utan annan belastning och ändrade bara målvärdena för uppdelningen. Varje inställning använde samma 500 ställningar efter 20 uppvärmningsdrag, i tre körningar. Här visas medianer över de tre körningarna. GPU-tiden kommer från en separat körning med tidsstämplar.14
| Målvärde | Per drag | GPU-tid |
|---|---|---|
| Ingen uppdelning | 3,2 ms | 2,82 ms |
| 2 048 | 1,8 ms | 1,51 ms |
| 4 096 (standard) | 1,3 ms | 0,98 ms |
| 8 192 | 1,0 ms | 0,72 ms |
Utan split-K tog ett drag ungefär 2,5 gånger så lång tid som med
standardinställningen. Ytterligare uppdelning nådde 1,0 ms på denna GPU.
Standardvärdet förblir 4 096 tills fler enheter har mätts. Det är en
utgångspunkt för finjustering, inte ett fastställt optimum. Körmiljön har
inställningarna splitTarget och qkvSplitTarget för det ändamålet.
Experimentet ändrade båda tillsammans och behöll modell, precision och
kernelkod oförändrade.14
Körmiljön håller också ihop arbetet. Ett drag köar 70 små beräkningsjobb i en enda kommandobuffert, skickar den en gång och läser tillbaka bara sju poängvärden. I den tidigare precisionsjämförelsen var GPU-tiden med fp32 ungefär 0,92 ms, och uppvärmda drag tog cirka 1,3 ms. Att skicka arbetet och få tillbaka resultatet spelar roll på den här tidsskalan.
Med fp16- och int8-vikter var GPU-tiden 0,59 respektive 0,66 ms. Ett helt drag tog 0,9 respektive 1,0 ms. Dessa bråkdelar av en millisekund spelar mindre roll för spelaren än int8-filens betydligt mindre nedladdning. Lägre precision i vikterna tar inte bort kostnaden för att skicka arbetet och läsa tillbaka resultatet.1
För en arena som utvärderar många bräden erbjuder batchning en annan avvägning. Vid 64 ställningar per anrop blev den uppmätta tiden per ställning 0,32 ms med fp32-vikter och 0,24 ms med fp16. Det ökar genomströmningen, men förkortar inte väntan på ett enskilt drag. Den publicerade ONNX-grafen har en fast batchstorlek på ett, så ONNX Runtime Web kan inte batcha den filen. Vår specialiserade körmiljö kan det. Det interaktiva spelet behöver bara ett beslut i taget.1
I experimentet med olika målvärden gav alla fyra inställningar ungefär 0,32 ms per ställning vid batchstorlek 64. Med många bräden att bearbeta samtidigt gav uppdelningen av summorna ingen mätbar förbättring av genomströmningen i detta test.14
För en liten arbetsmängd med en enda ställning kan sättet att fördela arbetet spela större roll än att minska antalet räkneoperationer.
Medan du tänker vilar GPU:n
Prestandatestet ber om hundratals beslut i rad. Det gör inte en människa.
När spelet kördes i ett synligt Chrome-fönster på en M1 Max kunde det första draget efter en paus kosta tiotals millisekunder extra, trots att GPU:ns tidsstämplar fortfarande visade ungefär samma beräkningstid. Beteendet stämde med att GPU:n och dess webbläsarprocess återgick från vila. En minimal inskickad uppgift för att hålla dem aktiva löste inte problemet. En riktig modellkörning gjorde det.15
Spelet animerar redan brickan när den faller ned på brädet. Nu använder det den tiden till att värma upp modellmotorerna och mäter beslutet först när uppvärmningen är klar. På den M1 Max-datorn kom det uppmätta draget åter ned till ungefär 5 ms efter pauser. Uppvärmningen är extra arbete som ryms i en befintlig animation. Den ingår inte i den visade dragtiden och gör inte hela förloppet från klick till drag till en operation på en millisekund.16
Mät även pausen före nästa beslut. Ett ständigt uppvärmt prestandatest kan missa just den fördröjning som en människa möter när hon använder appen.
Från en snabb siffra till ett användbart samspel
Vi tränade inte om AI-modellen för det här resultatet. En körmiljö byggd kring dess specifika beräkningar gjorde uppvärmda beslut mycket snabbare och tog bort merparten av koden som behövde laddas ned utöver modellen. Kontroller av dragvalen, adaptern och det första draget efter en paus gjorde förbättringarna användbara även utanför prestandatestet.
Omfattningen är fortfarande liten: en modellfamilj, med de rapporterade mätningarna från Chrome på Apple silicon. Andra webbläsare, telefoner och trådkonfigurationer för WebAssembly behöver egna tester. Koden, modellfilerna, protokollet och mätningarna är offentliga, så det är experiment som andra utvecklare kan ta vidare.
För fyra i rad är den exakta lösaren fortfarande en utmärkt motståndare. Den större möjligheten är att lära en liten modell ett användbart beslut och sedan få det beslutet att fungera smidigt i ett vanligt program. Ett spel ger oss en rolig plats att öva på och dig ett sätt att själv pröva avvägningarna.
Körmiljöns källkod, demots kod och modellfilerna finns där om du vill följa ett drag hela vägen. Hur mycket betänketid behöver din webbläsare?
Fotnoter
-
Hastighetsmätningen på en M5 Pro utan annan belastning, gjord den 27 september 2026 med körmiljö
94c8af9. Den redovisar varje körning, modellernas hashvärden, inlästa körmiljöfiler, GPU-adapter och tidtagningens gränser. Storlekar anges i decimala enheter och exkluderar modellfilerna. ONNX Runtimes JavaScript och WebAssembly omfattar totalt 14 314 404 byte; onepass-webgpu är 37 464 byte. Gzip och demoversionen: körmiljöns README. ↩ ↩2 ↩3 ↩4 ↩5 -
Kompilatorn som skapar planen i förväg, körmiljöns implementation och grafidentifieringen i webbläsaren. Testets inläsning använder den förberedda planen. Direkt ONNX-inläsning är en separat testad väg för de poängsättningsmönster som stöds, inte generell ONNX-körning. ↩ ↩2
-
Det fastställda hastighetsprotokollet. Korrektheten kontrolleras före tidtagningen. Jämförelsen över hela utvärderingsmängden är ett separat test. Chromes dokumenterade klockupplösning är ungefär 0,1 ms; de avrundade medianerna är inte mätningar med mikrosekundprecision. ↩
-
Microsofts prestandaguide för ONNX Runtime Web förklarar kravet på cross-origin isolation för flera WebAssembly-trådar. De uppmätta sidorna rapporterar
crossOriginIsolated: false. ONNX Runtime är MIT-licensierat och används här som referensimplementation. ↩ -
Fullständig jämförelse för fp32 och fp16. Testerna använde Chrome 153 på en M1 Max och demots egen kodväg. Samma valda kolumn innebär inte bitidentiska poäng. ↩
-
Jämförelse för int8 med enbart kvantiserade vikter. Referensen är NumPy-implementationen av körplanen med avkvantiserade vikter och float32-aritmetik. WebGPU och ONNX Runtimes int8-variant valde samma kolumn i 17 058 av 17 325 ställningar. ↩
-
Kontroller av direkt ONNX-inläsning, med exakta storlekar för GPU-viktbuffertarna och separata referenser för varje fil. ↩
-
Tidsmätningar av hela partier i samma webbläsare och mätsidan. Slumpfrö 2026;
connect-four-ai-wasm1.0.0 med dess öppningsbok. Lösaren poängsätter alla tillåtna drag och behåller sin cache inom varje parti. Överensstämmelsen på 91,7 procent med bästa drag gäller WebGPU-modellen med fp32; tidstabellen innehåller även andra körvarianter. Modellernas tider gäller sekventiella, uppvärmda körningar utan mänskliga pauser. Denna mätserie är separat från både hastighetsprotokollets 500 ställningar och den interaktiva sidans test med 200 bräden. ↩ ↩2 -
Ruoss med flera, Amortized Planning with Large-Scale Transformers: A Case Study on Chess, 2024. Författarna tränade modeller med upp till 270 miljoner parametrar på ställningar märkta av Stockfish och rapporterade spel på stormästarnivå i blixtschack utan explicit sökning. Det är besläktad forskning, inte ett resultat från vår körmiljö. ↩
-
Avvisning av mjukvaruadaptrar och kravet på hårdvaruadapter i protokollet. Mjukvaruresultatet ledde till adapterkontrollen; det ingår inte som en giltig jämförelse av GPU-hastighet. ↩
-
Det offentliga receptet för fyra i rad: konvertering av MLX-checkpoint och ONNX-exportör. Exportören namnger
context_ids,option_idsochoption_maskoch gerlogitssom utdata. Den kontrollerar valda drag mot PyTorch-modellen. Den valfria int8-kvantiseringen följer efter fp32-exporten. ↩ -
W3C:s livscykel för WGSL-shaders beskriver stegen för shadermodul, pipeline och exekvering. Chromes Dawn-implementation innehåller WGSL-kompilatorn Tint och GPU-backender. Vår körmiljös pipelinecache är separat från eventuell cachning i webbläsaren eller GPU-drivrutinen. ↩
-
Split-K-kernels och ackumulering av delresultat samt konstruktion av kommandobufferten. Den offentliga hastighetsmätningen skiljer GPU-tidsstämplar från den uppvärmda tiden för hela beslutet. ↩ ↩2 ↩3
-
Jämförande mätning av målvärden för split-K, 28 september 2026. M5 Pro utan annan belastning, Chrome 154 med Metal-adapter, fp32-vikter och fp32-aritmetik. Varje rad visar medianen av tre körningars medianer. Uppvärmd dragtid mäts över 500 ställningar per körning; GPU-tidsstämplar använder en separat körning med 200 ställningar. Båda målvärdena varieras tillsammans; med båda satta till 1 blir det en enda del per matrismultiplikation. Den uppmätta revisionen
9dbc4f3ändrar bara testverktygen jämfört med artikelns låsta körmiljöversion. Det isolerar de nuvarande uppdelningsinställningarna, inte de historiska omskrivningarna av kernels eller attention. ↩ ↩2 ↩3 -
Testet med vilopauser och körmiljöns uppvärmningsråd. Dessa observationer under utvecklingen gäller en M1 Max med ett synligt Chrome-fönster, inte mätningarna på en M5 Pro utan annan belastning. ↩
-
Brickanimation och uppvärmning i demot. Sidan kontrollerar referensresultat innan den litar på WebGPU-spelaren och faller tillbaka till WebAssembly om kontrollen misslyckas. Dess interaktiva siffror beror på läsarens dator och sidans eget urval av ställningar. ↩