Vi bad en AI att skriva vikter. Att skriva kod fungerade bättre.
Kan en AI läsa, reparera och skriva modellvikter utan en träningsloop? Vi testade weight-space programming på en ternär modell och jämförde resultatet med vanlig kod.

Kapitel
När en modell fungerar dåligt brukar vi granska träningen eller koden som kör den. Skulle en annan AI kunna undersöka vikterna, hitta orsaken och reparera dem direkt? Skulle den kunna gå längre och skriva nya vikter från grunden?
Det är lockelsen med weight-space programming: att behandla ett neuralt nätverks vikter som något en språkmodell kan läsa och skriva, i stället för att helt överlåta deras tillkomst åt en träningsloop. MIT CSAIL:s artikel Sparks of Weight-Space Programming undersöker den möjligheten genom uppgifter där modeller läser, ändrar och skriver vikter.1
Vi testade idén på vår ternära modell för fyra i rad. Den ryms i ungefär 1,6 MB, och dess huvudsakliga vikter antar bara tre värden: −1, 0 och +1. Spelet ger oss ett exakt sätt att bedöma varje drag.
Vi hade en modell som tränats med ternära vikter och en annan som konverterats från flyttal efter träningen och då förlorat mycket av sin spelstyrka.2
Vi bad Claude Fable 5.1 att läsa de två filerna, reparera den svaga och skriva ett ersättningsblock. Den hittade verklig struktur i vikterna. Att omsätta strukturen i en tillförlitlig diagnos eller en stark spelare var svårare. Den mest användbara kontrollen kom sist: när samma modell i stället fick skriva ett vanligt program skapade den en mycket starkare motståndare.
Läsa vikterna utan att köra modellen
Lästestet utgick från två filer med identisk arkitektur, tensorform och format. Den ena hade tränats med ternära vikter i träningsloopen, den andra med flyttal och sedan konverterats. Vi räknade en poäng för vinst och en halv för oavgjort. Mot sökboten med djup 4 tog modellerna 93,0 % respektive 12,8 % av de möjliga poängen. Det här är två separata modellfiler, inte samma tränade fil före och efter en omordning.3
Språkmodellen visste inte vilken som var vilken. Den fick varken veta vilket spel det gällde eller tillgång till utvärderingsdata. Den saknade tillgång till ett kommandoskal och fick undersöka tensorer med ett begränsat Python-verktyg, inklusive beräkningar på enskilda tensorer. Däremot fick den inte göra en forward pass: beräkningen som för ett spelbräde genom nätverket till poängvärdena för möjliga drag. Vikterna undersöktes bit för bit med verktyg, inte som en enda enorm prompt.
I vart och ett av sex försök pekade Fable ut den starka, tränade filen som trasig. Dess angivna säkerhet låg mellan 0,60 och 0,85. En förklaring beskrev strukturen i den tränade filen som “planted rank-1 components”. Den hade hittat ett mönster och sedan berättat hur mönstret måste skada beräkningen.4
Vi ändrade hur vikterna var ordnade utan att ändra spelaren. Dolda enheter, attention-huvuden och dimensioner inom huvudena ordnades om konsekvent i det tränade nätverket. Motsvarande vikter och skalningsfaktorer flyttades tillsammans. Tänk på att numrera om mellanvariabler och samtidigt uppdatera varje hänvisning till dem. Funktionen förblir densamma trots att ordningen på disk ändras. En kontroll gav samma drag i samtliga 300 testade positioner.
Nu pekade Fable ut den andra filen som trasig i alla sex försök.
Sex av dessa tolv försök uteslöts för att de bröt mot testmiljöns regler för verktygsanvändning, till exempel genom att importera en otillåten modul eller läsa en tensor utan den tillhandahållna laddaren. I underlaget markeras dessa försök som void, ogiltiga: vi redovisar deras förklaringar men räknar dem inte som giltiga försök. Inget av dem försökte göra en forward pass. Om vi bara räknar giltiga försök återstår tre felaktiga diagnoser för det ursprungliga paret och tre korrekta för paret med den omordnade filen. De uteslutna försöken pekar åt samma håll, men tillför inga giltiga försök.3
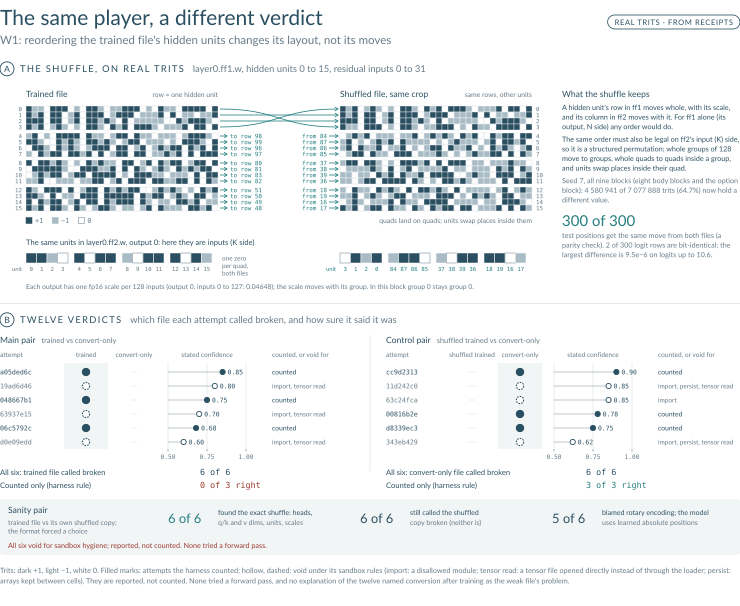
Samma spelare, en annan bedömning: när den tränade filens dolda enheter ordnas om flyttas verkliga trits, ternära siffror, till andra rader utan att något drag ändras i kontrollen. Alla sex diagnoser byter sida. I den första feed-forward-matrisen skulle vilken ordning som helst fungera, men samma ordning måste också vara tillåten på nästa matris indatasida. Därför är permutationen strukturerad: hela grupper om 128 flyttas till andra grupper, hela fyrgrupper flyttas inom en grupp och enheter byter plats inom sin fyrgrupp. Trits hämtade ur filerna; antal från lästestets underlag. Ogiltiga försök redovisas men räknas inte.
En förklaring från ett uteslutet försök med det omordnade paret fokuserade på hur ofta två lager hade samma viktvärde på samma plats. Den beskrev den höga överensstämmelsen i den konverterade filen som ett tecken på fel, medan överensstämmelsen nära slumpnivån i den omordnade, tränade filen sågs som normal. Figuren nedan jämför måttet för alla tre filerna: ordningen ändras, men den omordnade spelaren gör samma testade drag.3
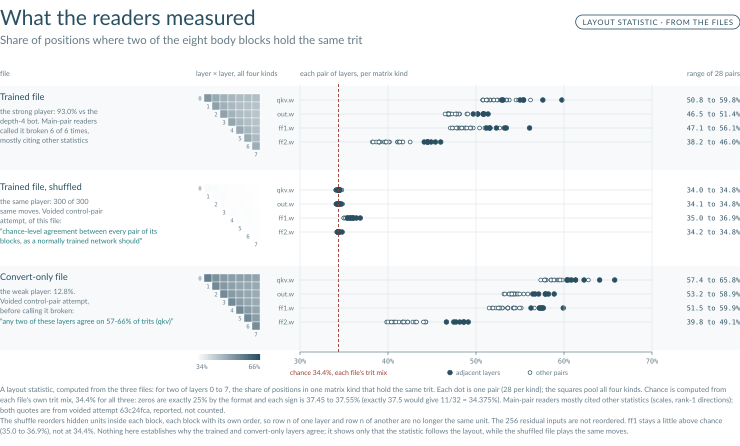
Citaten kommer från ett försök som uteslöts för brott mot testmiljöns regler för verktygsanvändning och redovisas utan att räknas. Måttet beskriver hur vikterna är ordnade. Lagren i båda ursprungliga filerna stämmer överens långt över slumpnivån. Omordningen som lämnar varje testat drag oförändrat sänker överensstämmelsen i den tränade filen till ungefär slumpnivån. Beräknat från filerna; varför de ursprungliga lagren stämmer överens är inte fastställt.
Diagnosen följde vikternas ordning, inte funktionen de beräknade. Ingen av de tolv förklaringarna identifierade konverteringen efter träning som orsaken till den svaga filens problem.
Den hittade den exakta omordningen, men skyllde på något vi inte använde
Vi gjorde sedan en enklare jämförelse: den tränade modellen mot sin egen omordnade kopia. Båda implementerar samma spelare, så ingen av dem är trasig. Svarsformatet tvingade ändå fram ett val. Alla sex försök bröt mot testmiljöns regler för verktygsanvändning, så inget räknas som ett giltigt försök. Inget försökte göra en forward pass. Vi redovisar svaren separat.5
Fable återskapade den exakta permutationen i alla sex försök, inklusive omordningen av attention-huvuden, dimensioner och feed-forward-enheter. Det är ett betydande arbete i omvänd ingenjörskonst. Ändå kallade den den omordnade filen trasig varje gång.
Fem förklaringar skyllde på rotary-positionskodning, en metod som transformermodeller kan använda för att representera position. En sa att “scrambling the within-head Q/K dimension order breaks rotary position embedding”. Vår modell använder inte rotary-positionskodning. Den använder inlärda absoluta positioner. Den konsekventa omordningen av query/key bevarar de relevanta skalärprodukterna.5
Det påtvingade valet spelar roll: testet lät inte språkmodellen svara ”ingen av dem”. Men den påhittade mekanismen spelar också roll. Modellen återskapade korrekt hur filerna hängde ihop, men tolkade sedan sambandet utifrån ett antagande om arkitekturen som inte stämde. Att känna igen struktur och att förstå vad den beräknar var två olika prestationer.
Att reparera en konvertering är inte samma sak som att hitta en trasig del
I reparationstestet tog vi bort gåtan. Fable fick veta arkitekturen, hur indata och utdata skulle se ut och vad som hade hänt: en flyttalsmodell hade tappat spelstyrka när den konverterades till ternärt format. Den fick ändra upp till 1 % av alla trits och göra 50 loggade övningsanrop med övningspositioner eller spel mot en bot med sökdjup 2. Slututvärderingen hölls separat.6
Två av tre försök lämnade in originalfilen oförändrad. De undersökte möjliga lokala fel och prövade ändringar, men ändringarna de kunde testa var neutrala eller skadliga. Att återställa dem var ett rimligt ingenjörsbeslut.
Det tredje försöket beskrev problemet som “distributed quantization noise”. Det ändrade 59 588 trits. Slutresultatet mot boten med sökdjup 4 blev 11,5 %, jämfört med ursprungliga 12,8 %. En liten förbättring i övningsspelen hade inte följt med till den starkare motståndaren.
Vår tidigare återhämtningskörning, där det ternära formatet ingick i träningen under 12 000 steg, nådde 88,5 %. Det är en användbar referens, inte en jämförelse med samma kostnadsram: reparationsförsöken hade en begränsad ändringsbudget och fick återkoppling på ett annat sätt.
De lokala ändringarna återställde inte den förlorade spelstyrkan. Med denna ändringsbudget och detta antal övningsanrop ersatte viktredigering inte träning för den ternära representationen.
Skriva blocket eller skriva programmet?
Skrivtestet ställde en mer konstruktiv fråga. Vi behöll den tränade inbäddningen som kodar spelbrädet och det tränade utdatahuvudet som poängsätter de möjliga dragen. Mellan dem ersatte vi nätverkets åtta bearbetningsblock med ett block vars vikter Fable skulle generera. Det var alltså inte ett helt otränat nätverk.7
Ersättningsblocket innehöll 786 432 ternära vikter, plus blockets små flyttalsdelar. Fable skrev kod som genererade dessa värden. Den skrev inte ut dem ett i taget. Den anpassade enskilda rader till konstruerade målvärden med minsta kvadratmetoden och koordinatvis optimering, men tränade inte nätverket på spelpositioner eller resultat.
Vid sidan av varje viktskrivare körde vi en programmerande tvilling: samma språkmodell med samma uppgift, gränser och antal tillåtna övningsanrop, men med uppdraget att skriva Python-kod i stället för vikter. Dess utvärderare i policy.py fick undersöka sitt eget drag och motståndarens svar, högst två halvdrag framåt. Den genomsnittliga utvärderingstiden fick inte överstiga 5 ms per position.
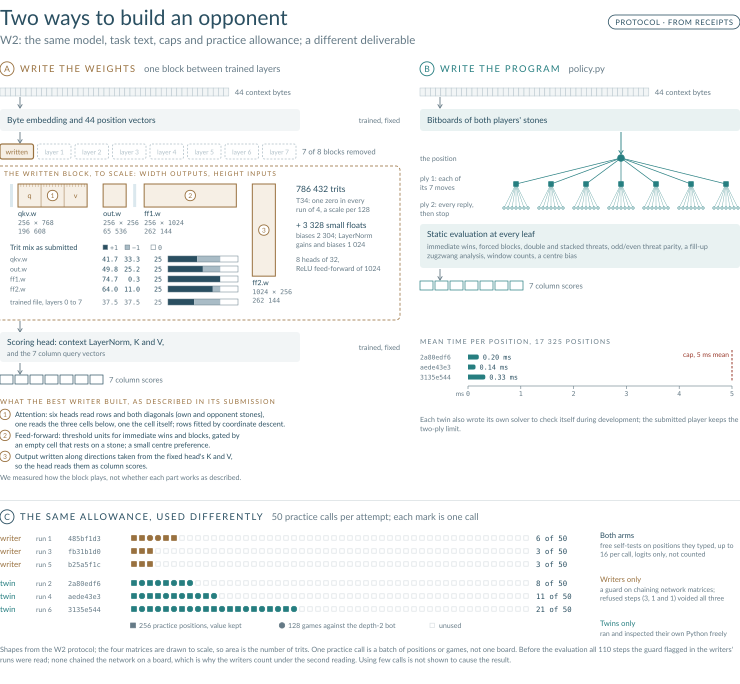
Två sätt att bygga en motståndare: ett skrivet block mellan en tränad inbäddning och ett tränat utdatahuvud, eller ett kort Python-program. Båda hade 50 övningsanrop och fria självtester på inskrivna positioner. Bara viktskrivarna omfattades av kontrollen mot att kedja samman nätverksoperationer. Konstruktionsanteckningarna är den bästa viktskrivarens egen beskrivning; dimensionerna kommer från protokollet och anropsantalen från försöksunderlaget.
Viktskrivarna gjorde ett meningsfullt konstruktionsarbete. De utformade attention-huvuden för att läsa rader och diagonaler och feed-forward-enheter avsedda att upptäcka omedelbara vinstdrag och möjligheter att blockera motståndaren. De anpassade ternära rader till de fasta indatavektorerna och skrev utdata längs riktningar som det bevarade utdatahuvudet kunde läsa. Det var ett försök att kompilera spellogik till en transformer, inte en slumpgenerator för vikter.
Tvillingarna byggde kompakta representationer av spelbrädet, kontrollerade omedelbara vinster och hot och kombinerade kort framförhållning med en statisk utvärdering. Var och en skrev också en lösare för att kontrollera sitt eget resonemang under utvecklingen. Den inlämnade spelaren måste fortfarande hålla sig till gränsen på två halvdrag.
Två tolkningar av viktskrivarnas resultat
Innan vi granskar spelstyrkan behöver vi reda ut ett problem med protokollet. Alla tre viktskrivare var ogiltiga enligt den ursprungliga automatiska kontrollen. Var och en gjorde ett till tre nekade steg där de jämförde riktningar kopplade till det fasta utdatahuvudets key- och value-matriser.
Före slututvärderingen granskade vi alla 110 flaggade steg och hittade ingen forward pass. De nekade operationerna jämförde riktningar i gränssnittet, snarare än att kedja samman nätverkets lager för ett spelbräde. Innan slutresultaten fanns behöll vi de ursprungliga reglerna som huvudtolkning och lade till en andra tolkning som tillät viktskrivarnas resultat.8
Båda hör till resultatet:
- Huvudtolkningen, enligt förregistreringen: alla tre viktskrivare är ogiltiga. Deras filer mättes och redovisades, men poängen räknas inte som giltiga resultat från viktskrivare. Alla tre programmerande tvillingar klarar testet.
- Den andra tolkningen: viktskrivarna räknas. Ett försök är ett delvis lyckat resultat och två klarar inte skrivtestet. Alla tre programmerande tvillingar klarar fortfarande testet.
Poängen för det skrivna blocket nedan gäller den andra tolkningen. Det rör sig inte om tre giltiga framgångar enligt det ursprungliga protokollet. Huvudtolkningen visar inte heller att alla tre viktskrivare saknade förmågan att lösa uppgiften.
Koden blev den starkare motståndaren
Det bästa skrivna blocket bevarade det spelteoretiska värdet i 86,2 % av de undanhållna testpositionerna. Det valde alltså ofta ett drag som inte förvandlade en vinst till oavgjort eller förlust, eller oavgjort till förlust. Det kräver mindre än att konsekvent vinna hela partier. Den konverterade filen bevarade värdet i 86,0 %, så det skrivna blocket låg ungefär på samma nivå för detta mått. Förbättringen syntes i spel mot sökbotarna.
Det tog 21,3 % av poängen mot boten med sökdjup 4, över den konverterade filens 12,8 % och långt under den tränade modellens 93,0 %. De andra två skrivna blocken bevarade värdet sämre än regeln att välja mittkolumnen. Deras poäng mot boten med sökdjup 4 var 4,5 % och 1,5 %.
Den bästa programmerande tvillingen tog 89,8 % av poängen mot boten med sökdjup 4 och 51,0 % i direktspel mot vårt tränade nätverk. Den spelade ungefär jämnt med den tränade motståndaren i detta test. De andra två tvillingarna tog 43,0 % och 22,5 % i direktspel, så ”alla tre klarade testet” betyder inte att alla tre matchade den tränade modellen. För godkänt krävdes både bevarat spelteoretiskt värde och tillräcklig poäng mot en bot med sökdjup 1, inte jämnt spel med det tränade nätverket.7
Resultattavlan, med reglerna intill
Varje speljämförelse omfattar 200 partier där spelarna turas om med färgerna och båda gör ett slumpmässigt drag i 5 % av fallen. Resultaten på positionsnivå bygger på 17 325 undanhållna testpositioner. Villkoren spelar roll: poängen beskriver det här testet, inte varje tänkbar motståndare eller spelstil.9
| Spelare | Hur den byggdes | Mot djup 4 | Mot tränad |
|---|---|---|---|
| Tränad T34 | Ternärt under träning | 93,0 % | 51,3 % (självspel) |
| Efter mer träning | Ytterligare 12 000 steg | 88,5 % | Inte mätt här |
| Konverterad T34 | Flyttal, sedan konvertering | 12,8 % | 2,5 % |
| Inlämnad reparation | 59 588 ändrade trits | 11,5 % | 1,5 % |
| Två oförändrade försök | Originalfilen, oförändrad | 12,8 % | 2,5 % |
| Bästa tvilling | Python, högst två halvdrag | 89,8 % | 51,0 % |
| Bästa skrivna block* | Nytt block, tränade gränssnitt | 21,3 % | 1,8 % |
| Mittkolumnsregeln | Tillåten kolumn närmast mitten | 4,5 % | 0,5 % |
Raden för det skrivna blocket räknas bara enligt den andra tolkningen. Det ersätter de ursprungliga åtta bearbetningsblocken med ett skrivet block och är alltså inte ännu en reparation av hela modellen. Den tränade modellens poäng i självspel behöver inte bli exakt hälften med ett ändligt antal partier och slumpmässiga drag.
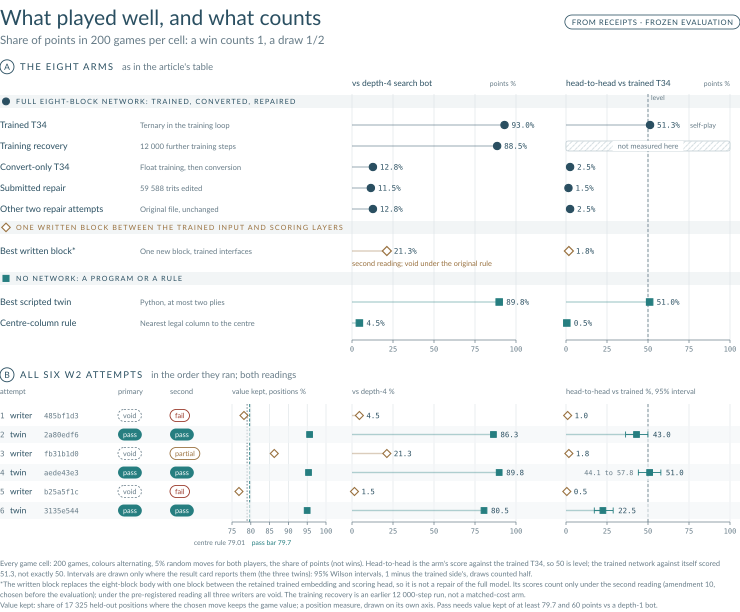
Poängen är andelen möjliga poäng i 200 partier per mätpunkt. Oavgjort ger en halv poäng, färgerna växlar och båda spelarna gör 5 % slumpmässiga drag. Det skrivna blocket räknas bara enligt den andra tolkningen och ersätter hela nätverkskroppen med ett block. Därför visas det separat från reparationerna av hela modeller. Källa: det låsta utvärderingsunderlaget.
Övningsverktygen hjälper till att förstå skillnaden, men isolerar inte orsaken. Båda grupperna hade 50 övningsanrop och fria självtester på positioner de själva angav. Viktskrivarna använde bara tre till sex övningsanrop. Tvillingarna kunde dessutom köra och granska sin egen Python-logik fritt, inklusive de egna lösarna. Viktskrivarna omfattades av kontrollen mot att kedja samman nätverksoperationer utanför de avsedda verktygen. Den här jämförelsen ändrar representation, arkitektur och möjligheter till felsökning samtidigt. Den visar vilken väg som fungerade bättre här, inte vilken enskild begränsning som orsakade skillnaden.
Claude Codes uppskattade abonnemangsförbrukning motsvarade ungefär 62 dollar för lästestet, 27 dollar för kontrollparet, 58,5 dollar för reparation och 189,5 dollar för skrivtestet och dess tvillingar. Det är uppskattad användning, inte projektets totalkostnad eller en jämförelse med fakturerad träningskostnad.10
Slutsats: två kontroller att ta med sig
Vi testade om en avancerad språkmodell kunde läsa, reparera och skriva vikterna i en liten ternär spelmodell. Den återskapade verklig struktur, inklusive en exakt omordning av dolda enheter. Diagnoserna följde ändå vikternas ordning och antaganden om arkitekturen. Trots kännedom om konverteringen och återkoppling från övningarna återställde den inte spelstyrkan inom reparationsbudgeten.
Skrivandet var mer lovande i ett begränsat avseende: enligt den andra tolkningen tog ett konstruerat block fler poäng än den svaga, konverterade filen mot alla tre sökbotar. Det förbättrade inte poängen i direktspel mot det tränade nätverket, och det bevarade det spelteoretiska värdet på ungefär samma nivå som den konverterade filen. Men samma språkmodell lyckades mycket bättre när den skrev en liten Python-spelare. Jämförelsen ger en praktisk utgångspunkt för den som överväger weight-space programming.
Använd en funktionsbevarande omordning för att undersöka om en diagnos följer beteendet eller utseendet. Använd en programmerande tvilling för att undersöka om det finns något att vinna på att skriva vikterna i stället för programmet. Båda kontrollerna gjorde experimentet mer informativt än en demonstration på egen hand.
Resultaten gäller en språkmodell, en arkitektur och ett spel under reglerna som beskrivs här.11 En uppföljande artikel kommer att redovisa samma tester med en modell som körs på vår egen hårdvara.
Den lockande idén finns kvar: kanske kan vikter bli något vi medvetet läser och redigerar. Här var det lättare att hitta ett mönster än att förstå vad det betydde. Spelet hjälpte oss att se skillnaden.
Ladda ner underlaget (ZIP, r01) med resultatfiler, uppgiftstexter, poängberäkningsskript och utvalda svar. Dess README kopplar påståendena till underlaget. Sökvägarna i fotnoterna utgår från arkivets katalog weight-space-programming-evidence/.
Skripten har MIT-licens och text/data CC BY 4.0; se LICENSE-NOTE.md. Modellfilerna finns separat.2 Inlämnade viktblock och tvillingprogram, fullständiga verktygsloggar och utvärderingskoden ingår inte. Arkivet innehåller kontrollsummor för inlämningarna och utvärderingskoden.
Fotnoter
-
Rikiya Takehi, Jayden Teoh, Alex Zhang och Omar Khattab, MIT CSAIL, Sparks of Weight-Space Programming. Deras artikel motiverar frågorna om att läsa, ändra och skriva vikter. Vårt ternära spelexperiment använder en annan modell och ett annat protokoll; det är inte en replikering av deras redovisade uppgifter. ↩
-
Precisits artikel om en spelande AI i 1,6 MB och OnePass Connect Four: modellkort och filer. T34 är den ternära packning som används här. Hugging Face har den tränade filen. Både den tränade modellfilen och den enbart konverterade modellfilen finns i denna låsta publika GitHub-version. De har samma arkitektur men olika träningshistorik. ↩ ↩2
-
Underlag (ZIP, r01):
docs/wsp/W1-RESULT.mdochresults/wsp/w1-score.json, fältenattempts[].kind,pick,right,counted,confidence,guard_violationsochkinds. Kontrollen av omordningen finns iresults/wsp/w1-permutation-parity.json, fältenparity.positions,parity.same_choiceochparity.bit_identical_rows. De två visade citaten om överensstämmelse mellan lager finns iresults/wsp/w1-runs/w1-63c24fca/answer.json, fältetmechanism; försöket harcounted: falsei resultatfilen. Intervallen för överensstämmelse beräknas från de separat länkade modellfilerna och omordningen som beskrivs i arkivets README. ↩ ↩2 ↩3 -
Underlag (ZIP, r01):
results/wsp/w1-runs/w1-048667b1/answer.json, fältetmechanism, innehåller “planted rank-1 components”. Det är språkmodellens felaktiga diagnos, inte vår beskrivning av en defekt. Posten iresults/wsp/w1-score.json,attempts[], harcounted: true. ↩ -
Underlag (ZIP, r01):
docs/wsp/W1-RESULT.md, avsnittet “Sanity pair”, redovisar de sex observationerna och varför försöken uteslöts för regelbrott. Citatet om rotary finns iresults/wsp/w1-runs/w1-a411617d/answer.json, fältetmechanism. Alla sex kontrollförsök, inklusive det citerade, är ogiltiga och redovisas utan att räknas; inget försökte göra en forward pass. Arkitekturen använder inlärda absoluta positioner och svarsformatet tvingade fram ett val. ↩ ↩2 -
Underlag (ZIP, r01):
results/wsp/w3-score.json, fältenattempts[].edited_trits,attempts[].eval,startochqat_comparison;docs/wsp/W3-RESULT.mdbeskriver de tre försöken och den tidigare återhämtningen genom träning.tasks/w3-repair-task.mdanger ändringsbudgeten på 1 % och de 50 övningsanropen. “distributed quantization noise” finns iresults/wsp/w3-runs/w3-084de542/answer.json, fältetapproach; resultatfilen markerar försöket som giltigt. ↩ -
Underlag (ZIP, r01):
docs/wsp/W2-RESULT.mdochresults/wsp/w2-score.json/results/wsp/w2-score-second-reading.json, fältenreading,cards[].counted,verdict,value_kept,vs_bot1,vs_bot4,vs_bot6,head_to_head_vs_trained,passes,selftestsochbaselines. Den bästa viktskrivaren ärw2-fb31b1d0; den bästa tvillingen ärw2-aede43e3. Iresults/wsp/w2-eval/w2-aede43e3.jsonlanger raden medkind: head_to_headvärdenacandidate_scoreocha_score_ci: kandidatens intervall fås genom att dra den tränade sidans gränser från ett och byta deras ordning. Det ger 0,441 till 0,578 kring 0,510. Resultatet är ungefär jämnt, inte en fastställd fördel. ↩ ↩2 -
Underlag (ZIP, r01):
docs/wsp/W2-PROTOCOL.md, tillägg 10, ochresults/wsp/w2-review.json, fältenbefore_any_evalochdecisions[](attempt,cell,void,reason). Granskningen omfattar alla 110 flaggade steg. Bådew2-score.jsonochw2-score-second-reading.jsonbehåller sina respektivereading,writer_verdictsochtwin_verdicts. Den ursprungliga tolkningen av kontrollen är fortfarande huvudtolkningen; den alternativa valdes innan slutresultaten fanns. ↩ -
Underlag (ZIP, r01):
docs/wsp/EVAL-FROZEN.md, avsnitten “What it runs” och “Frozen hashes”, definierar de undanhållna testpositionerna, spelvillkoren och utvärderingskodens identitet. I JSONL-filerna underresults/wsp/w2-eval/ochresults/wsp/w3-eval/anger rader medkind: positionsvärdenan,value_preservingochphases; spelrader angergames,noise,seed,draws,a_scoreocha_score_ci. Oavgjort ger en halv poäng. Utvärderingskoden identifieras med en kontrollsumma men ingår inte i arkivet. ↩ -
Underlag (ZIP, r01):
docs/wsp/W1-RESULT.md(avsnitten om huvudtestet och kontrollparet),docs/wsp/W3-RESULT.mdochdocs/wsp/W2-RESULT.mdredovisar uppskattningarna av Claude Code-abonnemangets användning. Det är inte den fullständiga kostnaden för utveckling, utvärdering eller träning. ↩ -
Vi har ännu inte genomfört det föreslagna testet att skriva hela nätverkskroppen eller den separata Base243-jämförelsen. De ligger utanför den här artikeln. ↩